RAG(検索拡張生成)とは?仕組み・業務での使い道・作り方の選び方をわかりやすく解説
RAG(検索拡張生成)とは、質問のたびに社内の文書などを検索し、見つけた箇所をもとに生成AIに答えさせる仕組みです。生成AIだけとの違い、ファインチューニングとの違い、業務での使い道、精度が落ちる所、作り方の選び方を、AIを自社で開発・運用する立場から解説します。
目次
1.RAG(検索拡張生成)とは
1-1.生成AIだけでは、社内のことに答えられない
1-2.RAGは「調べてから答える」
2.RAGの仕組み|答えるまでの流れ
2-1.前もって資料を取り込む
2-2.質問が来たら、探して、渡して、答える
3.RAGとファインチューニングなど、ほかの方法との違い
4.RAGの業務での使い道
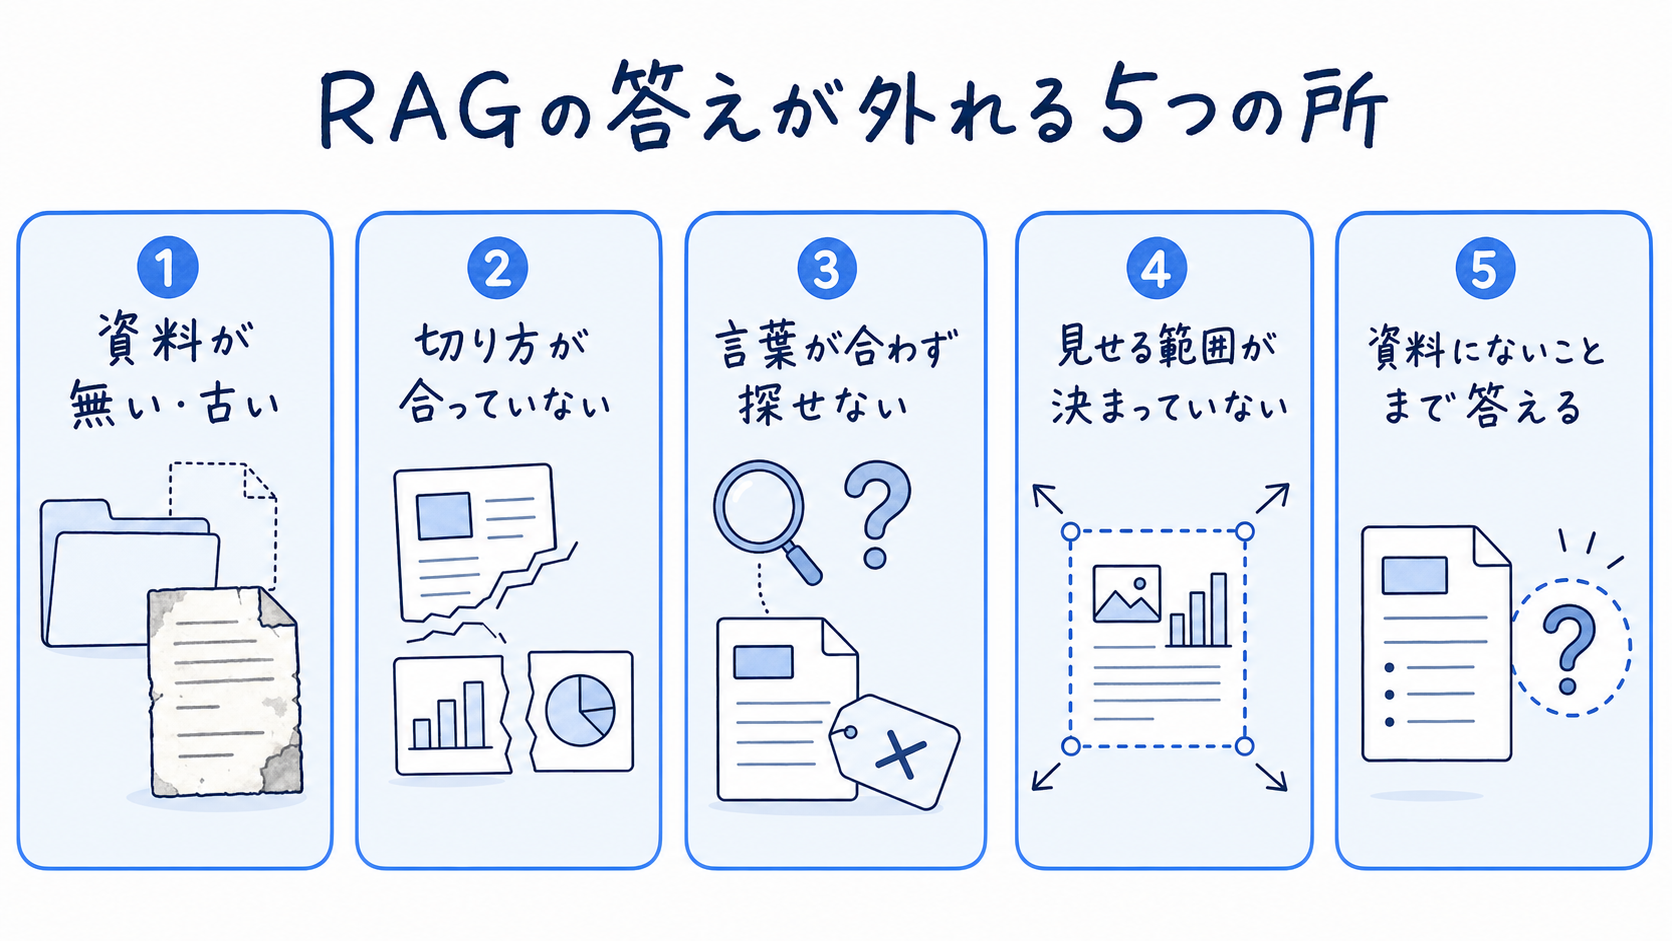
5.RAGの答えが外れる5つの所
5-1.1. 資料そのものが無い・古い
5-2.2. 資料の切り方が合っていない
5-3.3. 言葉が合わず、探せない
5-4.4. 見せてよい資料の範囲が決まっていない
5-5.5. 資料にないことまで答えてしまう
6.RAGの作り方|4つの選び方
7.当社の相棒AIでのRAGの使い方
8.まとめ
ChatGPT などの生成AIを仕事に使い始めると、すぐに壁に当たります。社内の規程や製品の仕様を聞いても、AIはその中身を知らないので、もっともらしい一般論か、事実と違う答えが返ってきます。そこで調べていくと「RAG」という言葉に行き当たり、社内の資料を読ませて答えさせる仕組みだと分かっても、何をどう作ればよいのかまでは見えにくいものです。
RAG(検索拡張生成)とは、質問のたびに社内の文書などから関係する箇所を探し、その箇所を生成AIに渡して答えさせる仕組みです。AIに社内のことを覚えさせるのではなく、毎回「調べてから答える」形にするので、文書を直せば答えも変わり、答えの根拠になった箇所も示せます。この記事では、RAGの仕組み、学習(ファインチューニング)との違い、業務での使い道、答えが外れやすい所、作り方の選び方を順に説明します。
RAG(検索拡張生成)とは
RAGは Retrieval-Augmented Generation の略で、日本語では検索拡張生成と訳されます。検索(Retrieval)で見つけた情報で、生成AIの文章づくり(Generation)を補う(Augmented)という意味です。
この呼び名は、2020年に発表された論文で広く知られるようになりました。論文では、モデルの中に覚えた知識だけで答える方法に対し、外の文書の索引から検索して引いてきた情報と組み合わせて答える方法として RAG を示しています(出典: Lewis ほか「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」(2020年5月))。
生成AIだけでは、社内のことに答えられない
生成AIは、公開されている大量の文章で学習したモデルです。一般的な知識や文章の組み立ては得意ですが、学習に使われていない社内の規程や手順書、取引先とのやり取りは知りません。知らないことを聞かれても、それらしい文章を作ってしまうため、間違いに気づきにくい点が業務では困りものです。
学習したあとに変わった情報にも答えられません。社内の規程は改定され、製品の仕様は版が上がり、担当者も入れ替わります。AIが答えるべき中身が変わり続ける業務では、覚えている知識だけに頼るやり方には限界があります。AIが間違える理由の全体は「AIの間違い(ハルシネーション)はなぜ起きる?」の記事でも整理しています。
RAGは「調べてから答える」
RAGは、AIに知識を足すのではなく、答える前に資料を調べる手順を足します。人に例えると、何でも暗記している人ではなく、聞かれるたびに社内の棚から該当する資料を開き、その箇所を読んでから答える人に近い形です。
この形には、業務で使ううえで大きな利点が3つあります。資料を差し替えれば次の質問から答えが変わること、答えの根拠になった資料と箇所を示せること、そして見せてよい資料だけを検索の対象にできることです。
RAGの仕組み|答えるまでの流れ
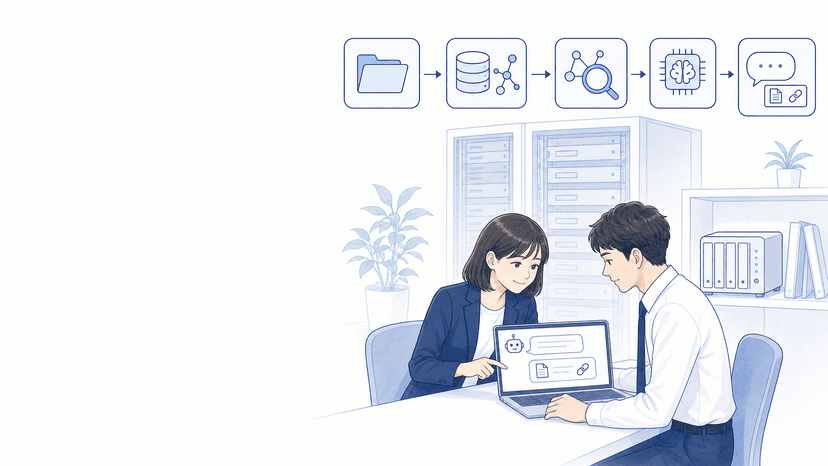
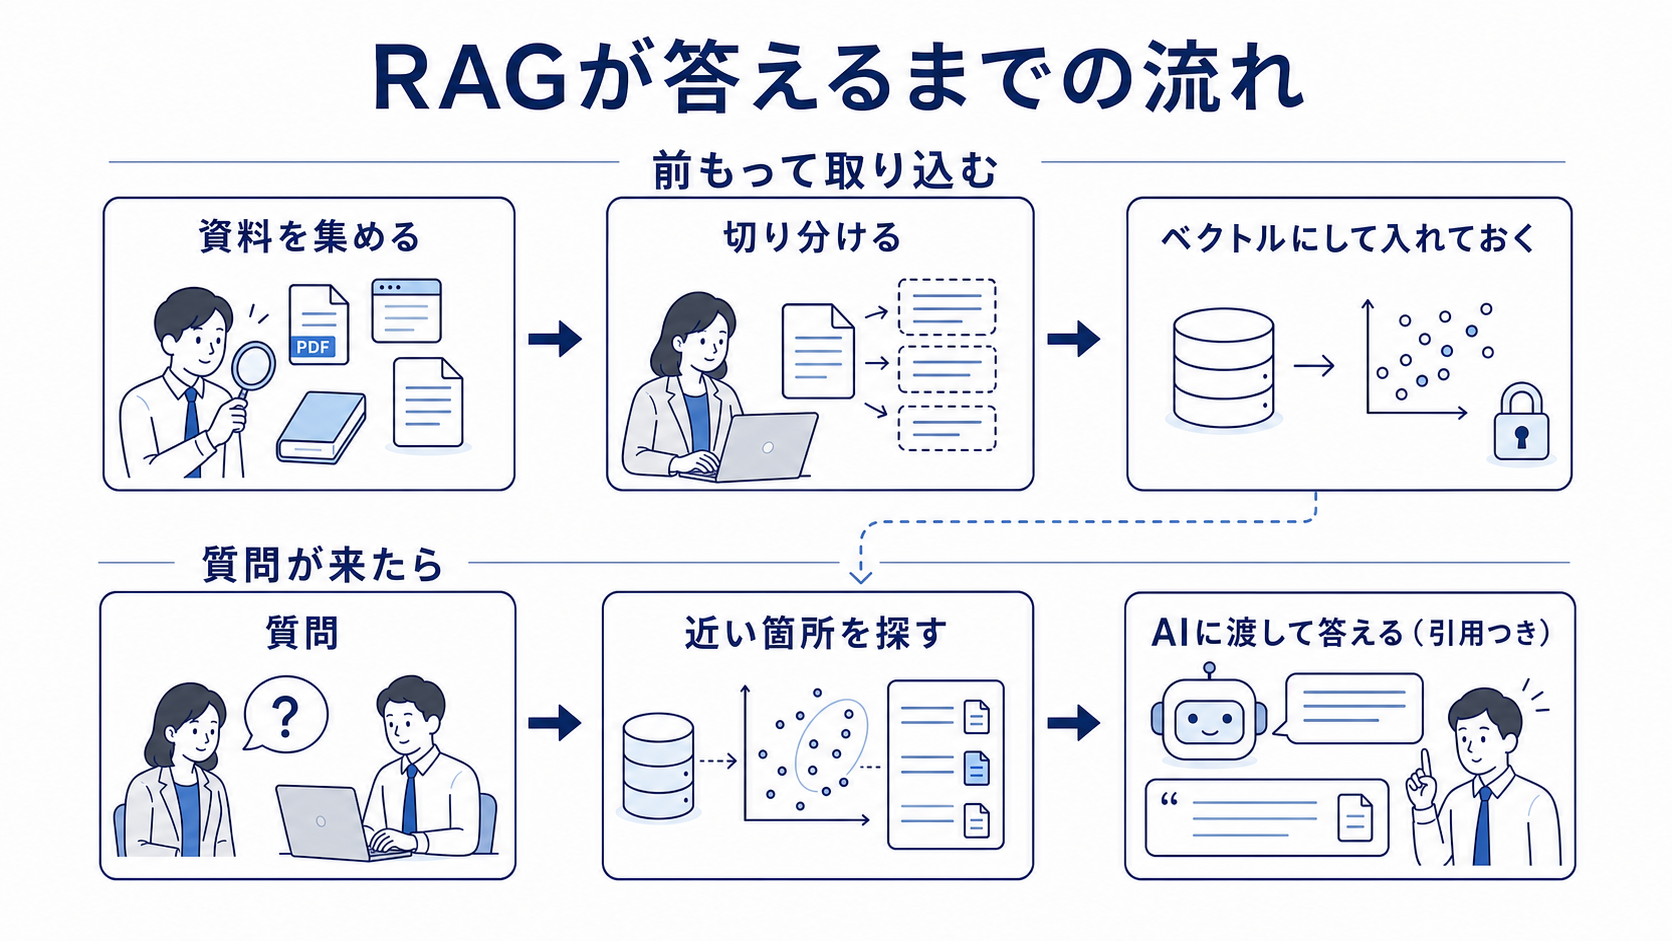
RAGの処理は、前もって資料を取り込んでおく段と、質問が来たときに答える段の2つに分かれます。
前もって資料を取り込む
まず、答えの元にする資料(規程・マニュアル・過去の記録など)を集め、検索しやすい大きさに切り分けます。1つの資料を丸ごと渡すと長すぎるので、見出しや段落の単位で区切るのが一般的です。
切り分けた文章は、埋め込み(エンベディング)と呼ばれる処理で、意味を表す数字の並び(ベクトル)に変えて、データベースに入れておきます。こうしておくと、言葉が完全に一致しなくても、意味の近い箇所を探せるようになります。
質問が来たら、探して、渡して、答える
社員が質問すると、その質問も同じ方法でベクトルに変え、データベースから意味の近い箇所をいくつか探します。製品の型番や条文の番号のように、言葉そのものが一致することが大事な場面では、昔ながらのキーワード検索と組み合わせることもあります。
見つけた箇所は、質問と一緒に生成AIへ渡されます。このとき「渡した資料の範囲で答えること」「どの資料のどこを使ったかを示すこと」といった指示も添えます。生成AIは渡された箇所をもとに答えの文章を作り、利用者は引用を開いて元の資料を確かめられます。
段 | やること | 主に使うもの |
取り込み | 資料を集めて切り分け、ベクトルにして入れておく | 埋め込みモデル・ベクトルを入れるデータベース |
検索 | 質問に近い箇所を探す | 埋め込みモデル・キーワード検索 |
生成 | 見つけた箇所と質問をAIに渡し、答えを作る | 生成AI(大規模言語モデル) |
RAGとファインチューニングなど、ほかの方法との違い
社内の情報をAIに使わせる方法は、RAGだけではありません。よく比べられるのは、モデルを追加で学習させるファインチューニングと、資料をそのままAIに添付して聞くやり方です。
方法 | 向いていること | 向いていないこと |
資料を添付して聞く | 手元の数点の資料について、その場で聞く | 資料が多いとき、毎回探して添付する手間がかかる |
RAG | 多くの資料から、書かれた事実で答える・根拠を示す | 資料に書かれていないことを補う |
ファインチューニング | 言い回しや答えの形式をそろえる | 細かい事実を正確に覚えさせる・改定のたびに直す |
ファインチューニングはモデルの中身を調整する方法で、答え方の型をそろえるのは得意ですが、改定が続く事実を覚えさせて正しく引き出させる用途には向きません。どの資料から来た知識かを示せない点も、業務では扱いにくいところです。社内の資料で答えるAIの土台はRAGで作り、言い回しのばらつきが気になったときに学習を足す、という順が手戻りの少ない進め方です。学習とRAGの違いは、社内のサーバーで動かす場合に絞って「ローカルLLMでRAGを組む」で詳しく比べています。
最近は一度に渡せる文章の量が大きい生成AIも増え、資料を全部まとめて渡せば検索は要らないのでは、という声もあります。数点の資料ならその方法で足りますが、部署の資料が数百、数千とある場合や、人によって見せてよい資料が違う場合は、質問ごとに必要な箇所だけを探して渡すRAGの考え方が引き続き役に立ちます。
RAGの業務での使い道
RAGが向いているのは、答えが社内のどこかの資料に書かれているのに、探すのに時間がかかる業務です。ここでは、たとえばこういう場面を考えてみます(いずれも想定の例です)。
使い道 | 元にする資料 | 聞かれることの例 |
社内の問い合わせ窓口 | 就業規則・経費の規程・社内の手続きの案内 | 出張の日当はいくらか、休暇の申請はいつまでか |
現場の手順の確認 | 作業手順書・設備の取扱説明書・点検の記録 | この警告が出たときはどうするか |
過去の対応の参照 | 問い合わせの記録・不具合の報告書・日報 | 同じ症状は以前にあったか、そのときどう直したか |
顧客対応の下調べ | 製品の仕様書・よくある質問・提案書 | この製品はこの条件で使えるか |
どの使い道でも共通するのは、答えを決めるのはAIではなく資料だという点です。資料が古い、書かれていない、部署ごとに食い違っている、という状態のままRAGを入れても、AIはその資料どおりに答えます。業務日報や不具合の報告書を引けるようにする話は「日報AIの使い方」や「再発防止策の書き方」でも触れています。
RAGの答えが外れる5つの所
RAGを入れたのに答えが外れる、という相談の原因は、生成AIの性能より手前にあることが少なくありません。答えが外れるときは、次の5つの所のどこで止まっているかを順に見ていきます。
1. 資料そのものが無い・古い
答えが書かれた資料が取り込まれていなければ、どれだけ検索しても見つかりません。古い版と新しい版が両方入っていて、古い方を引いてしまうこともあります。どの資料を正とするかを決め、古い資料を外しておくのが先です。
2. 資料の切り方が合っていない
切り分けた単位が小さすぎると、条件と結論が別々の断片に分かれ、片方だけが見つかります。大きすぎると、関係の薄い文章まで一緒に渡され、答えがぼやけます。表や図の中身は、文字として取り出せていないこともあります。
3. 言葉が合わず、探せない
社員が使う呼び名と、資料に書かれた正式な名前が違うと、意味の近さで探しても届かないことがあります。製品の略称や社内の通称、部署ごとの言い回しは、言い換えの一覧を用意しておくと探しやすくなります。
4. 見せてよい資料の範囲が決まっていない
人事や経営の資料のように、読める人が限られる資料もあります。検索の段階で、質問した人が見てよい資料だけに絞らないと、AIが答えの中で中身を漏らしてしまいます。社外のサービスに資料を渡すときの注意は「ChatGPT・生成AIの情報漏洩はなぜ起きる?」、資料の中に紛れた指示でAIが操られる危険は「プロンプトインジェクションとは」で説明しています。
5. 資料にないことまで答えてしまう
探した箇所に答えが無いとき、生成AIが自分の知識で補って答えてしまうことがあります。資料に無いときは「資料には書かれていない」と返す指示を入れ、答えの中の引用が実際に渡した資料にあるかを確かめる仕組みを持たせると、外れた答えを減らせます。
RAGの作り方|4つの選び方
RAGを自社で使う方法は、大きく4つに分かれます。どれが正解ということはなく、資料の量、見せてよい範囲、作った後に誰が面倒を見るかで選びます。
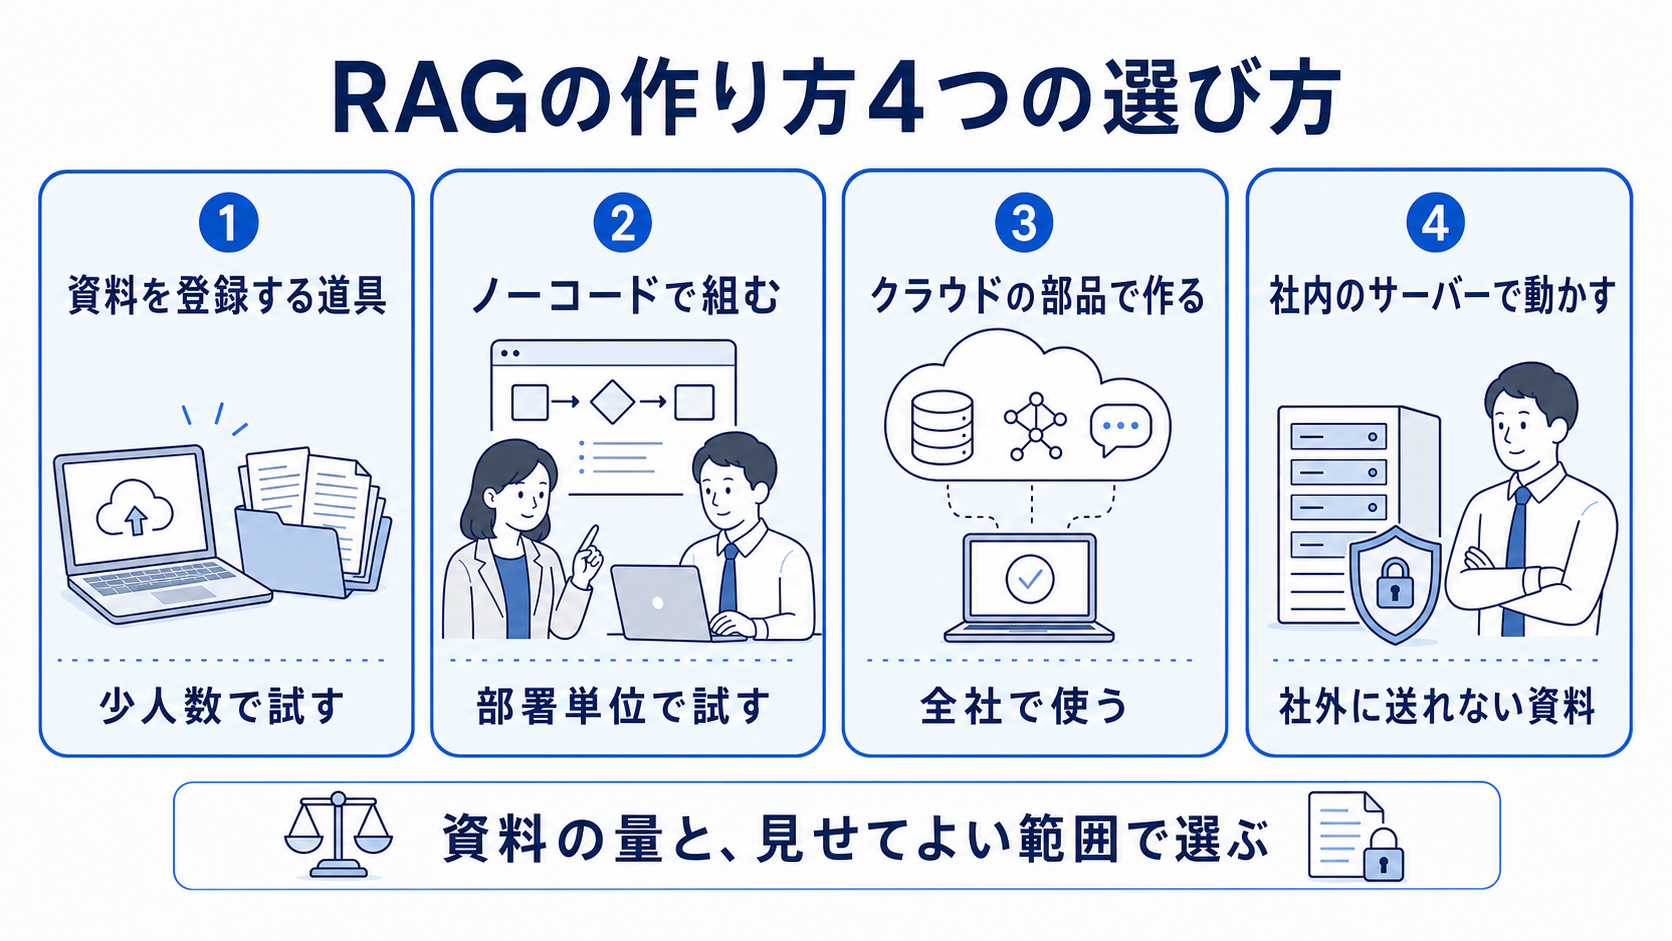
作り方 | 向いている場面 | 気をつけること |
資料を登録して答える道具を使う(NotebookLM など) | 少人数で、数十点までの資料を試す | 何が聞かれ、何に答えられなかったかを見る仕組みが弱い |
ノーコードの道具で組む(Dify など) | 社内に作れる人がいて、部署単位で試す | 作った人が異動すると止まりやすい |
クラウドの部品を組み合わせて作る | 既存の業務システムとつなぎ、全社で使う | 検索の調整と運用の担当が要る |
社内のサーバーで動かす(ローカルLLM) | 社外に送れない資料が中心 | 機械の用意と、モデルの更新を自社で持つ |
まずは手持ちの道具で小さく試し、答えられる質問と答えられない質問の傾向をつかむのがおすすめです。道具ごとにできることは「社内チャットボットを自作する前に」、全社で使う社内AIの作り方と進め方は「社内AIの構築方法」、社外に出せない資料を扱う場合は「ローカルLLMとは」で整理しています。すでに Microsoft 365 の Copilot を入れていて答えが弱いと感じている場合は、「Copilotが使えないと感じる理由」も参考になります。
どの作り方でも、入れて終わりにはなりません。RAGの答えの質を左右するのは、入れた後に「答えられなかった質問」を見て、資料を足したり直したりする流れがあるかどうかです。誰がその一覧を見て、誰が資料を直すのかを、作る前に決めておくと止まりにくくなります。社内でAIを使うときの決まりごとは「生成AIの社内ルールの作り方」にひな型を載せています。
当社の相棒AIでのRAGの使い方
当社(株式会社デイワン)は、社内の資料で答えるAI「相棒AI」を開発・提供しています。相棒AIは、社内の資料を横断して検索するRAGを標準の機能にしており、回答の文章は Claude で作り、検索のための埋め込みには OpenAI のモデルを使っています。
作りのうえで大事にしているのは2つです。1つは、答えに引用を付け、渡した資料に無い引用は出さないこと。もう1つは、何が聞かれ、何に答えられなかったかを管理者が見られるようにし、足りない資料や古い資料の直しにつなげることです。資料を読ませて答えさせるだけなら、手軽な道具でも同じことができます。差が出るのは、入れた後に答えの質を上げていく運用を、仕組みとして回せるかどうかだと考えています。
まとめ
RAG(検索拡張生成)は、質問のたびに社内の資料から関係する箇所を探し、その箇所をもとに生成AIに答えさせる仕組みです。
- 生成AIだけでは社内のことを知らないため、RAGで「調べてから答える」形にする
- 処理は、資料を切り分けてベクトルにして入れておく段と、質問に近い箇所を探してAIに渡す段に分かれる
- 事実で答えるならRAG、言い回しをそろえるならファインチューニング。土台はRAGで作る
- 答えが外れるときは、資料・切り方・言葉・見せる範囲・資料外の補い、の5つの所を順に見る
- 作り方は資料の量と見せる範囲で選び、答えられなかった質問を見て資料を直す担当を決めておく
社内の資料で答えるAIを検討していて、どの作り方が合うか迷っている場合は、お気軽にご相談ください。
あわせて読みたい:AIエージェントとは?、Claudeの使い方
よくある質問
- RAGとは何ですか。
- RAG(検索拡張生成)は、質問のたびに社内の文書などから関係する箇所を探し、その箇所を生成AIに渡して答えさせる仕組みです。AIに覚えさせるのではなく「調べてから答える」形にするため、文書を直せば答えも変わり、根拠の箇所も示せます。
- RAGとファインチューニングの違いは何ですか。
- RAGはモデルはそのままにして、質問ごとに文書を探して渡し、書かれた事実で答えさせる方法です。ファインチューニングはモデルの中身を調整して、言い回しや答えの形式をそろえる方法です。社内資料で答えるAIの土台はRAGで作るのが向いています。
- RAGは業務のどんな場面で使えますか。
- 答えが社内の資料に書かれているのに、探すのに時間がかかる業務に向いています。社内の問い合わせ窓口、作業手順や設備の取扱説明の確認、過去の対応記録の参照、製品仕様の下調べなどです。
- RAGを入れたのに答えが外れるのはなぜですか。
- 生成AIの性能より手前に原因があることが少なくありません。資料が無い・古い、切り方が合っていない、言葉が合わず探せない、見せてよい範囲が決まっていない、資料にないことまで答えてしまう、の5つの所を順に見直します。
- RAGはどうやって作ればよいですか。
- 資料を登録して答える道具、ノーコードの道具、クラウドの部品を組み合わせる方法、社内のサーバーで動かす方法の4つがあります。資料の量と見せてよい範囲で選び、答えられなかった質問を見て資料を直す担当を決めておくことが大切です。
次に読む記事
Claudeの使い方|業務で使う場面・プランの選び方・社内で続けるコツを、毎日使う会社が整理
記事を読むこの記事を書いた人
株式会社デイワン 代表取締役 月森 隼人
不動産コンサルタント、注文住宅やマンションなどの企画営業を経験し、大手広告代理店のデジタル部署にて、Web領域でのブランディングややディレクションなど上流から幅広く担当。