ローカルLLMに必要なスペックと機材の費用|GPU・VRAM・Mac miniの選び方と、人数で変わる目安
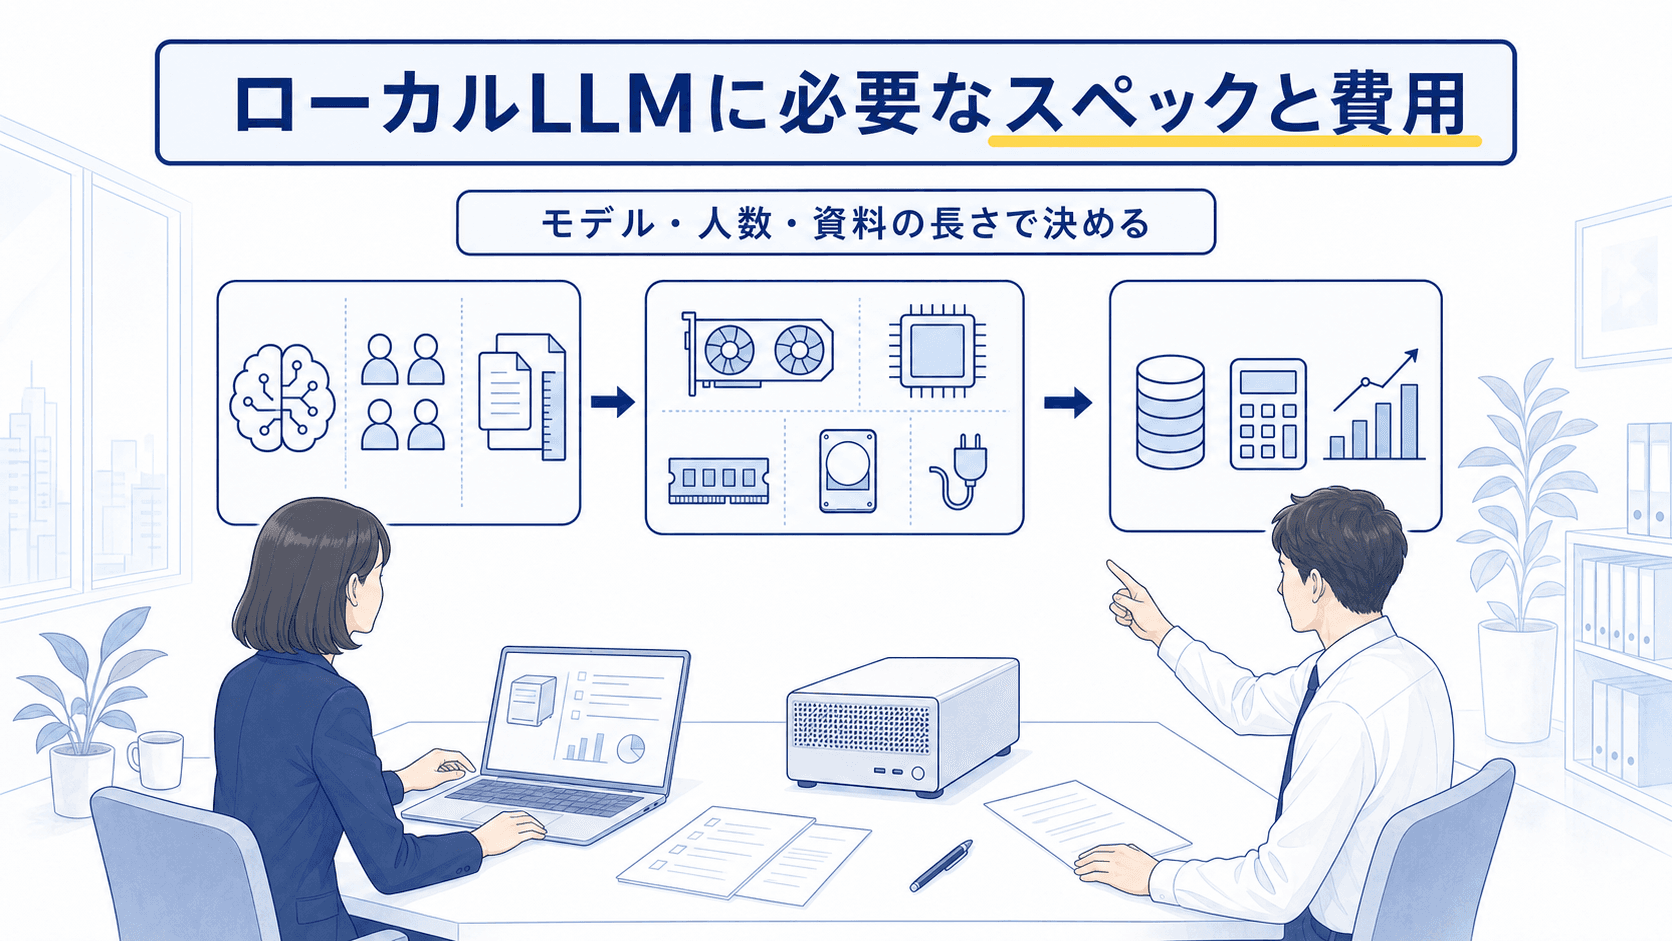
ローカルLLMを社内で動かすのに必要なスペック(GPU・VRAM・メモリ)と機材の費用の目安を、モデルの大きさ・同時に使う人数・読ませる資料の長さから考える方法で解説します。Mac mini・Mac Studio・GPUサーバーの段と、機材のほかにかかる費用も整理しました。
社内に置くAI(ローカルLLM)を考え始めると、最初に聞かれるのが「どんな機械を買えばいいのか、いくらかかるのか」です。調べるとGPUの型番やVRAMの容量、量子化といった言葉が並び、パソコン1台で足りるという記事もあれば、数百万円のサーバーが要るという記事もあって、どれが自社に当てはまるのか判断しにくいところです。
答えが記事によって大きく違うのは、前提にしている使い方が違うからです。1人が試しに動かすのと、社内の何十人が業務で毎日使うのとでは、同じモデルでも必要な機械がまるで変わります。
必要なスペックは、「どのモデルを」「何人で同時に」「どれくらい長い資料を読ませて」使うかの3つで決まります。この記事では、この3つから機械の大きさと費用の見当を付ける方法と、2026年11月時点で選べる機材の段、機材のほかにかかる費用を順に整理します。ローカルLLMがそもそも自社に向くかどうかは、ローカルLLMの導入ガイドで先に確かめておくと、ここでの見積もりが無駄になりません。
必要なスペックは「モデル・人数・資料の長さ」で決まる
ローカルLLMの速さと動くかどうかを一番左右するのは、GPUのメモリ(VRAM)か、Macのようにメモリを共有する機械ならユニファイドメモリの量です。モデルの重みがメモリに収まらないと、動かないか、動いても答えが返るまで待たされる状態になります。
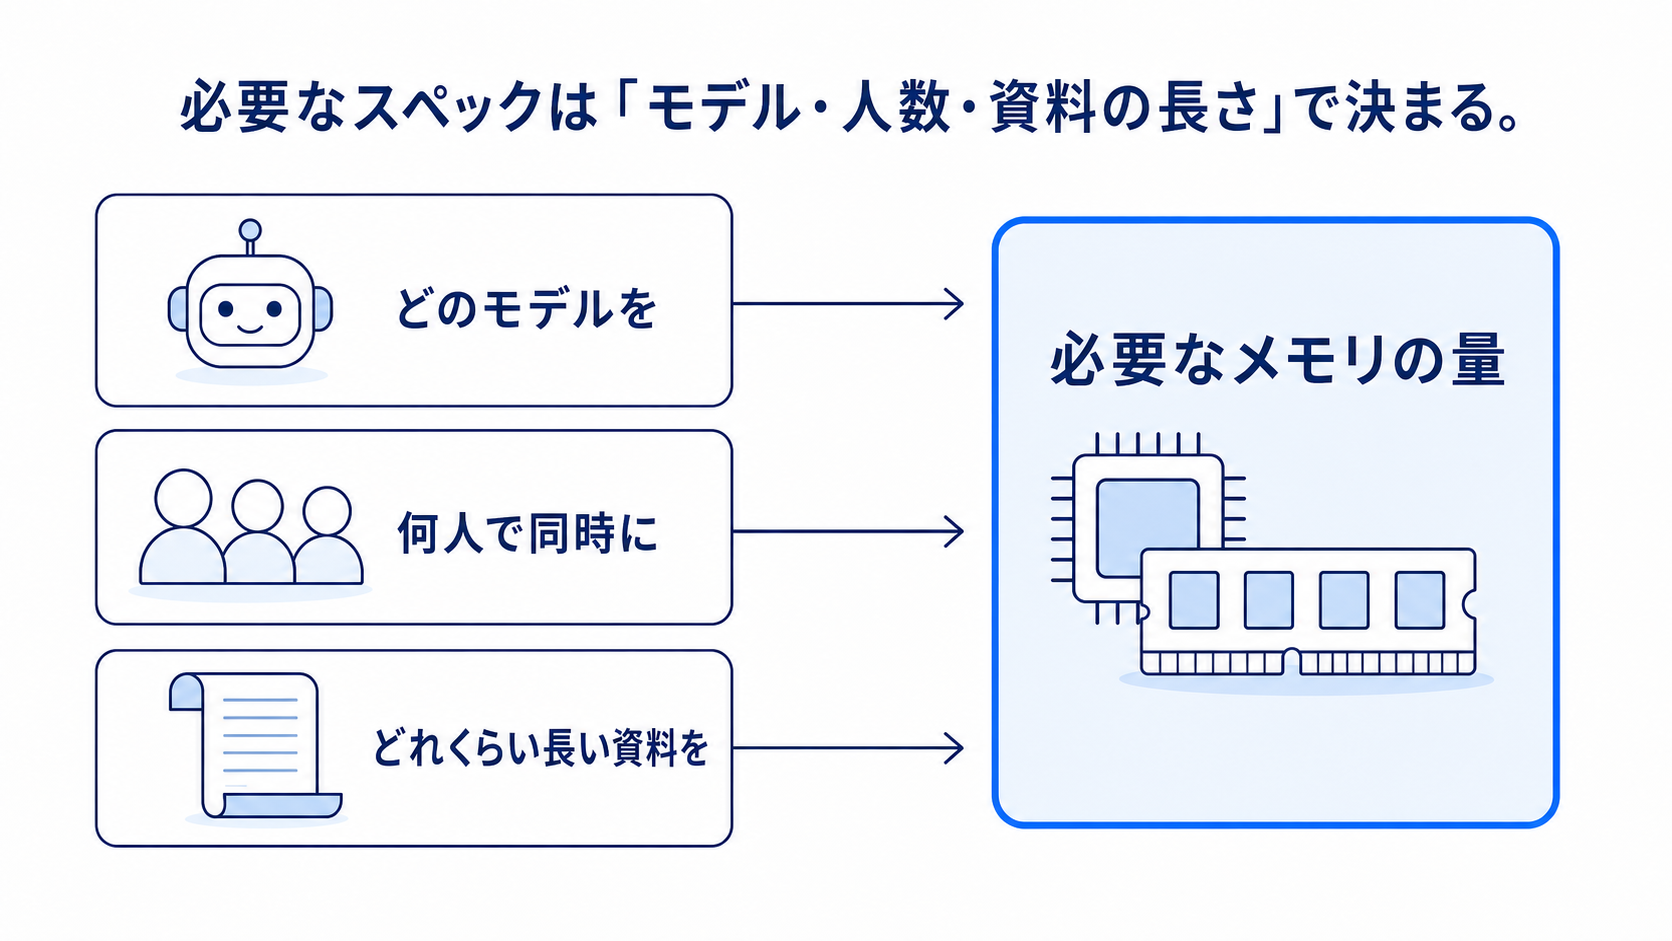
メモリの使い道は、モデルの重みだけではありません。会話や読ませた資料の内容も、答えを作る間はメモリに置かれます。そのため、同時に使う人が増えたり、1回に読ませる資料が長くなったりすると、同じモデルでも必要なメモリが増えていきます。上位の記事の多くは「このモデルならVRAM何GB」という1人で使う前提の数字を挙げていますが、業務で使うときは、人数と資料の長さの分を上乗せして考える必要があります。
決めること | 増えると何が変わるか |
どのモデルを使うか | 重みを置くメモリの量(モデルが大きいほど多い) |
何人で同時に使うか | 会話の内容を置くメモリと、計算の量 |
どれくらい長い資料を読ませるか | 1回あたりに置く内容の量と、答えが返るまでの時間 |
モデルの大きさと必要なメモリの目安
計算の仕方
モデルの大きさは、パラメータ(重み)の数で「7B(70億)」「70B(700億)」のように表されます。重みを置くのに要るメモリは、おおまかには「パラメータの数 × 1つあたりの大きさ」で見積もれます。1つあたりの大きさは、標準的な16ビットの形なら2バイト、量子化と呼ばれる方法で4ビットに縮めれば約0.5バイトです。
モデルの大きさ | 16ビットのまま(重みだけ) | 4ビットに量子化(重みだけ) |
7B(70億) | 約14GB | 約3.5GB |
30B(300億) | 約60GB | 約15GB |
70B(700億) | 約140GB | 約35GB |
この表は重みだけを掛け算した概算で、実際には前の節で書いた会話や資料の分と、動かすための道具の分が上乗せされます。表の数字に、少なくとも数割の余裕を足して機械を選ぶのが無難です。
具体的な例として、OpenAI が公開しているモデル gpt-oss は、公式のモデルカードで、小さい方の gpt-oss-20b は16GBのメモリで動き、大きい方の gpt-oss-120b は80GBのGPU 1枚に収まると説明されています。どちらも重みの一部をあらかじめ量子化した形で配られており、ライセンスは Apache 2.0 です(出典: gpt-oss-20b のモデルカード(Hugging Face)、2026年11月8日に確認)。
量子化で小さくするときの注意
量子化は、重みの1つずつを粗い数字に丸めて、メモリを減らす方法です。7Bのモデルでも16ビットのままでは約14GBが要りますが、4ビットにすれば一般的なパソコンのメモリにも収まる大きさになります。
その代わり、丸めた分だけ答えの質が下がることがあり、どれだけ下がるかはモデルと業務によって違います。社内の資料や質問で、量子化したものとしていないもの(またはクラウドの生成AI)の答えを並べて比べてから使う方が安全です。
当社が製造業の顧客の取扱説明書(英語・ドイツ語を含む9本)を日本語に整形させて比べたときは、原文の型番が訳文に残った割合が、クラウドの Claude Sonnet の0.85に対し、Qwen2.5 7B は0.38、Qwen3 8B は0.72でした(2026年9月15日、MacBook Pro(M3 Pro・36GB)と Ollama で、同じ指示・同じ採点で1回ずつ測定)。小さなモデルは動いても中身を落としやすく、機械を選ぶ前に、自社の資料で答えの質を確かめる必要があると考えています。
機材の選び方と費用の目安(2026年11月時点)
機材は、大きく3つの段に分けて考えると選びやすくなります。価格は2026年11月8日に各社の公式ページで確かめたもので、変わりやすい数字です。
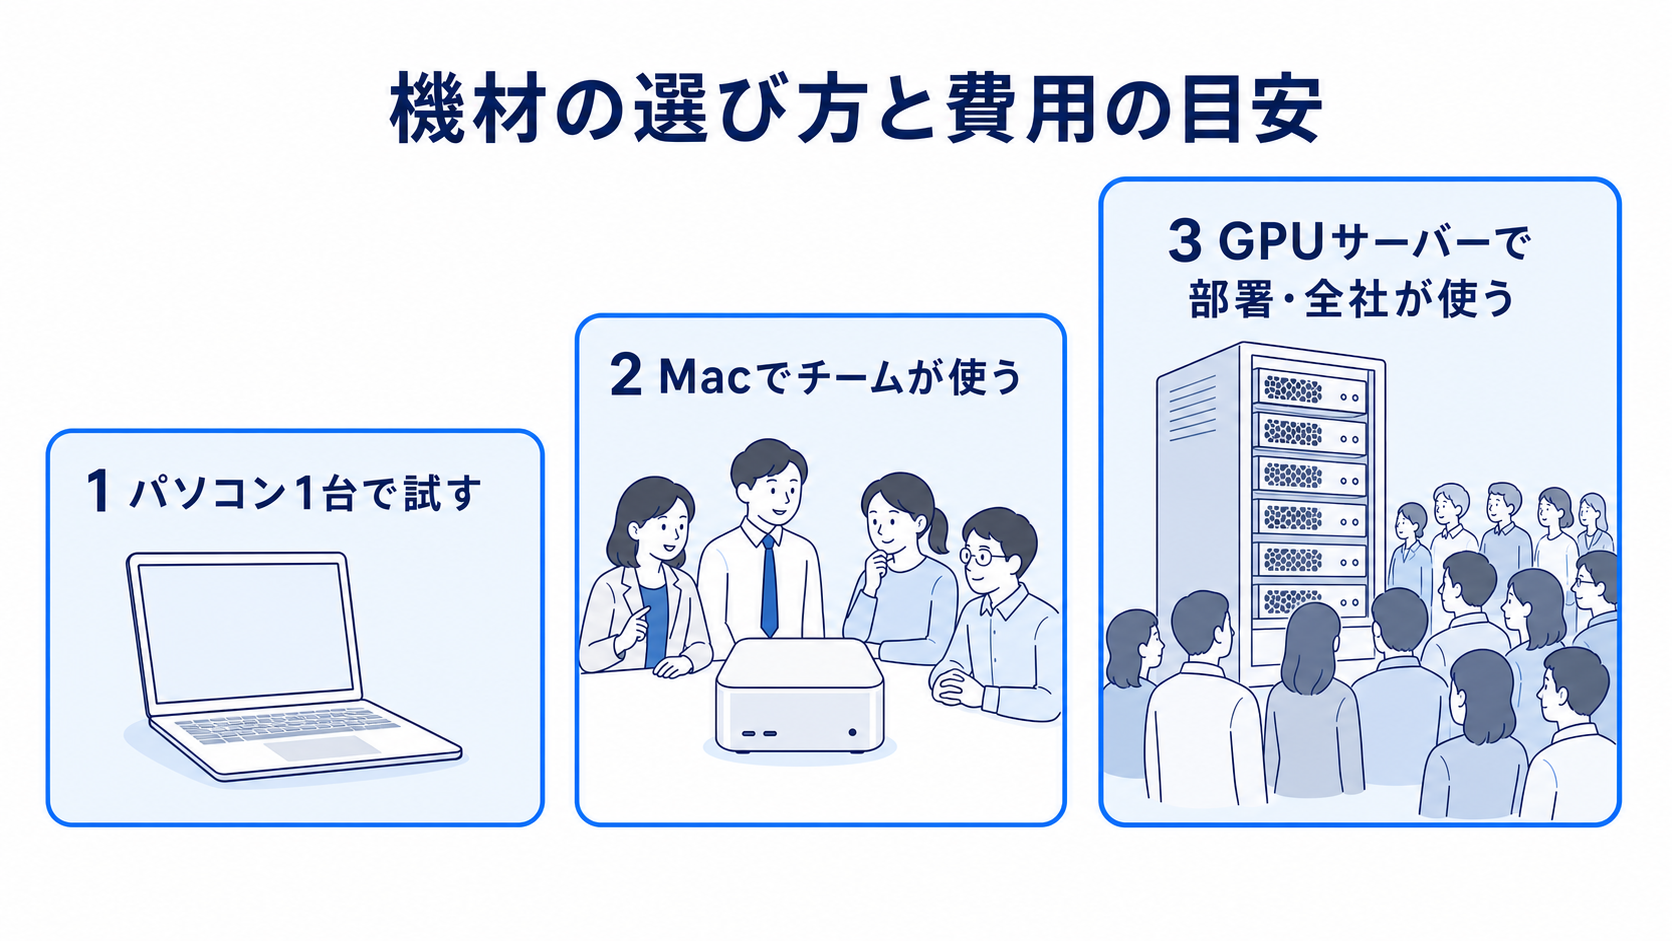
段 | 主な機材 | 使うメモリ | 向く使い方 |
1 試す | 今あるパソコン、Mac mini | 16〜32GB | 担当者が小さなモデルで答えの質を見る |
2 チームで使う | Mac mini(M5 Pro)、Mac Studio | 64〜512GB | 数人で中くらいのモデルを使う |
3 部署・全社で使う | GPUを積んだサーバー | GPU 1枚あたり32〜96GBなど | 多くの人が同時に、長い資料で使う |
パソコン1台で試す段
最初の段は、答えの質を見るための試しです。gpt-oss-20b のように16GBのメモリで動くよう作られたモデルなら、メモリが多めのパソコンで動かせます。試しの段では、機械を新しく買うより、今ある機械で小さなモデルを動かし、自社の資料と質問で答えが使えそうかを見る方が、後の判断に役立ちます。
Mac mini・Mac Studio
Macは、CPUとGPUが同じメモリ(ユニファイドメモリ)を使うため、GPUを別に積んだパソコンよりも大きなモデルを1台に載せやすい作りです。「mac mini ローカルllm」と調べる方が多いのもこのためです。
機種(2026年11月時点) | メモリの選択肢 | メモリ帯域 | 価格(税込・最小構成) |
Mac mini(M6) | 16〜32GB | 153〜170GB/s | 149,800円から |
Mac mini(M5 Pro) | 24〜64GB | 307GB/s | 299,800円から |
Mac Studio(M5 Max) | 36〜128GB | 460〜614GB/s | 419,800円から |
Mac Studio(M5 Ultra) | 96〜512GB | 1.2TB/s | 949,800円から |
出典: Apple の Mac mini 技術仕様・Mac Studio 技術仕様と各購入ページ(2026年11月8日に確認)。価格は最小構成のもので、メモリを増やすと上がります。
当社が2026年10月9日に Mac mini(M5 Pro・64GB)と Ollama 0.40.0 で同じ9本の整形を試したときは、Ollama がGPU用に使えたメモリは約50GBでした。Qwen3.6 35B-A3B(約24GB)や Gemma 4 31B(約21〜25GB)を1本ずつ載せるなら余裕がありましたが、2本(計約45GB)を同時に載せるのはほかのアプリの使う分しだいでぎりぎりで、実際には載り切らずに片方を下ろして入れ替える動きが記録に残りました。64GBのMacでも、中くらいのモデルを1本ずつ使う段だと考えるのが無難です。
速さの例として、その前に MacBook Pro(M3 Pro・36GB)で測ったときの文字を書き出す速さは、Qwen2.5 7B が毎秒25.2トークン、Qwen3 8B が21.7、Qwen2.5 14B が12.9でした(2026年9月15日・1回の測定)。モデルが大きくなるほど遅くなり、同じ取扱説明書の全体を仕様どおりの長さで書かせると、最も速い7Bでも休まず動かして約52日かかる見積もりになりました。量の多い作業では、1台のMacで足りるかを先に見積もっておく必要があります。
メモリ帯域は、答えの文字が出てくる速さに効きます。同じ量のメモリでも、帯域が広い機種の方が速く返る傾向があります。一方で、Macは1台で静かに動かせる反面、多くの人が同時に使う用途では、GPUサーバーほど人数を増やしにくい点に注意が要ります。
GPUを積んだサーバー
部署や全社で同時に使うなら、NVIDIA などのGPUを積んだサーバーが候補になります。GPUのメモリは製品で決まっていて、たとえば NVIDIA の公式ページでは、GeForce RTX 5090 が32GB、業務向けの RTX PRO 6000 Blackwell が96GB(最大の消費電力は600W)と示されています(出典: GeForce RTX 5090・RTX PRO 6000、2026年11月8日に確認)。
GPUの価格は公式ページに載っておらず、販売店や時期で大きく動くため、この記事では書きません。サーバー1台の費用は、GPUの枚数のほかに、電源・冷却・設置場所の条件で変わります。見積もりを取るときは、GPU単体の値段だけでなく、サーバー全体と設置までの費用で比べてください。
機材のほかにかかる費用
ローカルLLMの費用を機材の値段だけで比べると、あとで思わぬ出費が出てきます。クラウドの生成AIなら使った分を払えば済む部分を、自社で受け持つことになるためです。
費用 | 中身 |
電気代 | GPUは消費電力が大きく、毎日動かすと積み上がる |
設置・冷却 | サーバーの置き場、空調、騒音への対応 |
保守 | 故障した部品の交換、予備の機械 |
人の手間 | モデルの入れ替え、権限の管理、利用の記録の保管 |
組み立て | 社内の資料を読ませる仕組みや画面を作る費用 |
とくに見落としやすいのは人の手間です。新しいモデルが出たときに入れ替える人、動かなくなったときに直す人が社内にいないと、機械はあっても使われなくなっていきます。AI導入全体の費用の見方はAI導入の費用で整理しています。
使う量と比べる見方もあります。使う人が少ないうちは、クラウドの生成AIを使った分だけ払う方が安く済むことが多く、使う量が増えるほど、機械を持つ形の方が割に合いやすくなります。どこで逆転するかは使い方で変わるため、試しの段で1か月に何回・どれくらいの長さで使うかを記録しておくと、判断の材料になります。
買う前に決めておくこと
機材を先に決めると、買いすぎや足りなさが起きやすくなります。次の順で決めていくと、必要な機械の段が自然に絞れます。
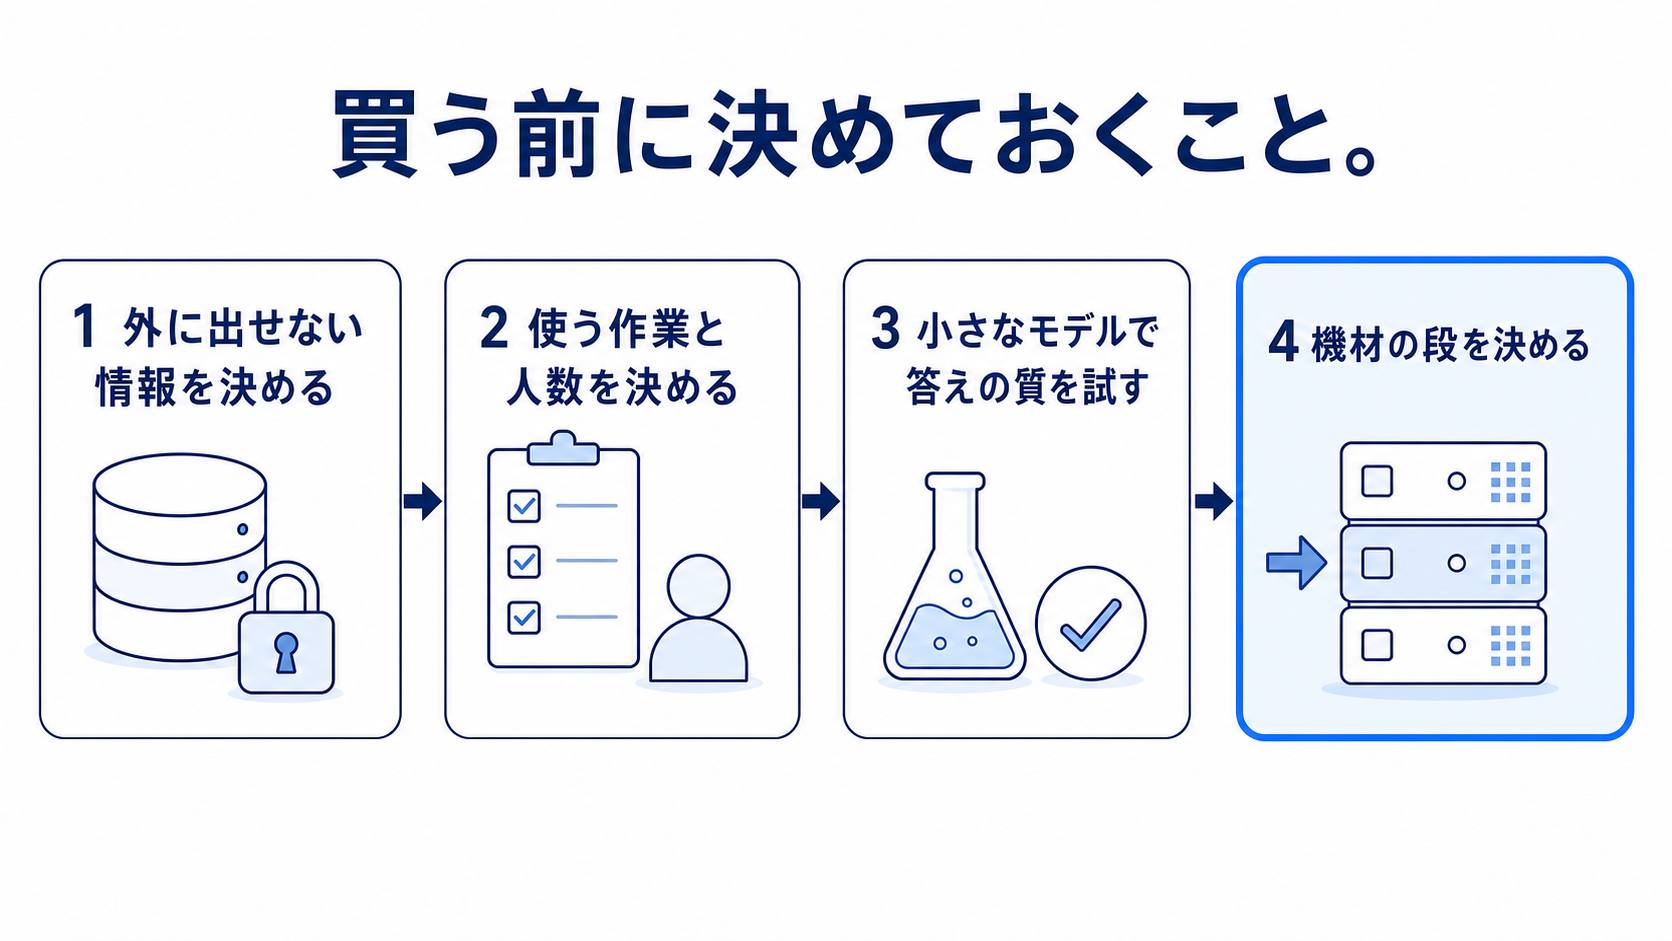
1つ目は、社外に送れない情報が何かを決めることです。ここが決まらないと、そもそもローカルLLMが要るのかが決まりません。クラウドの生成AIでも、学習に使わない設定で足りる場合があります。使ってよい情報の区分は、生成AIの社内ルールの作り方で詳しく書いています。
2つ目は、使う作業と、同時に使う人数、読ませる資料の長さを決めることです。3つ目で小さなモデルを実際の資料と質問で試し、答えの質が足りるか、大きなモデルが要るかを確かめます。そのうえで4つ目に、ここまでの結果から機材の段を決めます。
社内の資料を読ませて答えさせる使い方なら、モデルの大きさより、どの資料をどう読ませるかの方が答えの質に効くこともあります。仕組みの作り方は社内資料で答えるAIの作り方にまとめました。当社が自社で開発・運用している相棒AIは、回答の生成に Anthropic の Claude、検索の補助に OpenAI の埋め込みモデルと、クラウドのモデルを使っています。扱う資料が社外に送ってよいものであれば、機材を持たずに始める選択肢もあります。
まとめ
- 必要なスペックは「どのモデルを」「何人で同時に」「どれくらい長い資料を」の3つで決まる
- 重みのメモリは「パラメータの数 × 1つあたりの大きさ」で概算し、数割の余裕を足す
- 量子化でメモリは減るが、答えの質は自社の資料で比べて確かめる
- 機材は「試す」「チームで使う(Mac)」「部署・全社で使う(GPUサーバー)」の3段で考える
- 電気・設置・保守・人の手間まで含めて、クラウドの生成AIと比べる
ローカルLLMの機材は、買ってから足りないと分かっても取り替えにくいものです。まず外に出せない情報と使う人数を決め、小さなモデルで答えの質を試してから、機材の段を決めるのがおすすめです。当社のAIソリューション開発では、扱うデータの範囲を一緒に決めたうえで、社内のサーバーで動くAIで作ることもできます。
よくある質問
- ローカルLLMに必要なスペックは何で決まりますか。
- どのモデルを使うか、何人で同時に使うか、どれくらい長い資料を読ませるかの3つで決まります。中でもGPUのメモリ(VRAM)か、Macならユニファイドメモリの量が一番効きます。
- 必要なメモリはどう見積もればいいですか。
- 重みの分は「パラメータの数×1つあたりの大きさ」で概算できます。16ビットなら2バイト、4ビットに量子化すれば約0.5バイトで、7Bのモデルなら約14GBと約3.5GBです。会話や資料の分があるので、数割の余裕を足して選びます。
- Mac miniでローカルLLMは動きますか。
- 小さめのモデルなら動かせます。2026年11月時点の Mac mini はメモリを最大64GB(M5 Pro)まで選べ、gpt-oss-20b のように16GBのメモリで動くよう作られたモデルを試す段に向きます。多くの人が同時に使う用途では、GPUサーバーの方が人数を増やしやすくなります。
- ローカルLLMの機材にはいくらかかりますか。
- 段によって大きく違います。2026年11月8日時点の Apple の税込価格(最小構成)は、Mac mini が149,800円から、Mac Studio(M5 Ultra)が949,800円からです。GPUサーバーはGPUの枚数や電源・冷却で変わるため、サーバー全体と設置までの費用で見積もってください。
- 機材のほかにどんな費用がかかりますか。
- 電気代、設置と冷却、故障したときの保守、モデルの入れ替えや権限の管理をする人の手間、社内の資料を読ませる仕組みを作る費用がかかります。使う人が少ないうちは、クラウドの生成AIを使った分だけ払う方が安く済むことが多いです。
次に読む記事
ローカルLLMでRAGを組む|社内文書で答えるAIの仕組みと、学習(ファインチューニング)との違い
記事を読むこの記事を書いた人
株式会社デイワン 代表取締役 月森 隼人
不動産コンサルタント、注文住宅やマンションなどの企画営業を経験し、大手広告代理店のデジタル部署にて、Web領域でのブランディングややディレクションなど上流から幅広く担当。