ローカルLLMでRAGを組む|社内文書で答えるAIの仕組みと、学習(ファインチューニング)との違い
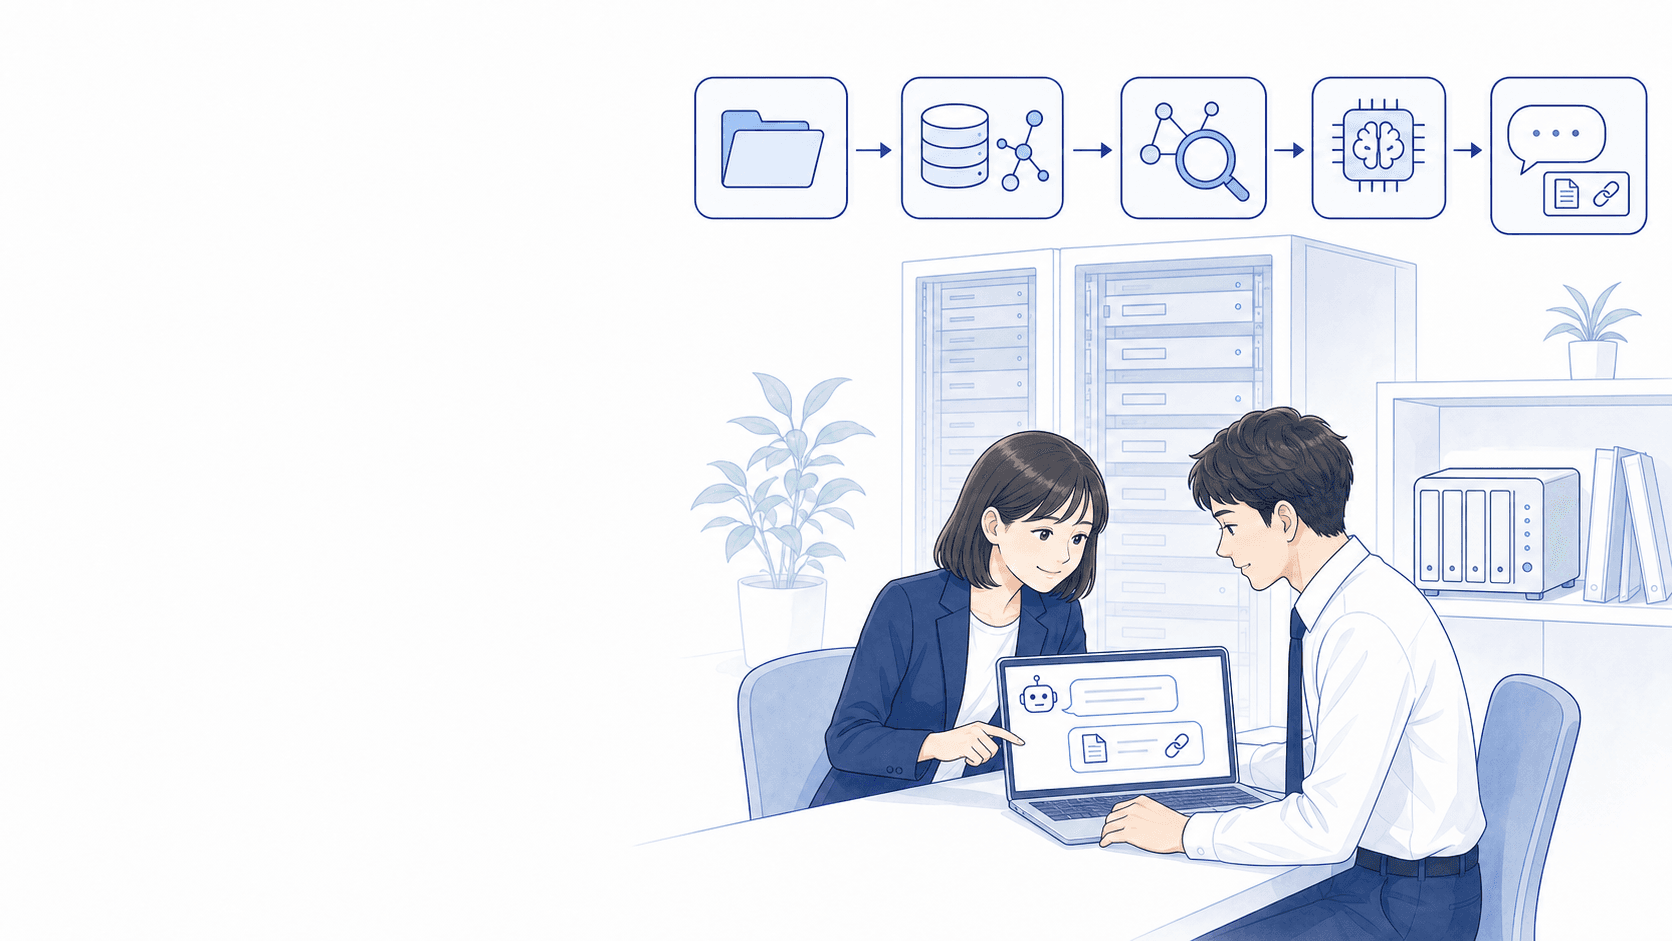
ローカルLLMとRAGで社内文書に答えるAIを作りたい企業向けに、学習(ファインチューニング)との違い、社内に置く3つのモデルと部品、日本語の埋め込みモデルの選び方、答えの質を確かめる方法と進め方を、AIを自社で開発・運用する立場から解説します。
社外に送れない資料が多いので、生成AIを社内のサーバーで動かしたい。ただ、ローカルLLMを入れてみると、会社の規程や製品のことを聞いても、もっともらしい一般論しか返ってこない。そこで「社内の文書をAIに学習させればよいのでは」と考え、学習(ファインチューニング)の方法を調べ始める方は少なくありません。
ところが、社内の文書を覚えさせて答えさせたいという目的には、学習よりもRAG(検索拡張生成)のほうが合うことがほとんどです。RAGは、質問のたびに社内の文書から関係する箇所を探し、その箇所をAIに渡して答えさせる仕組みで、ローカルLLMでも組めます。
ローカルLLMで社内文書に答えさせるなら、まずRAGで組み、学習は「答え方の型」をそろえたいときに後から考える、という順が近道です。この記事では、学習とRAGの違い、社内で動かすときに要る部品、日本語の文書で気をつけること、答えの質の確かめ方、進め方を順に説明します。ローカルLLMそのものが自社に向くかどうかや、機械の目安は「ローカルLLMの導入ガイド」で整理しています。
社内文書に答えさせたいなら、学習よりRAG
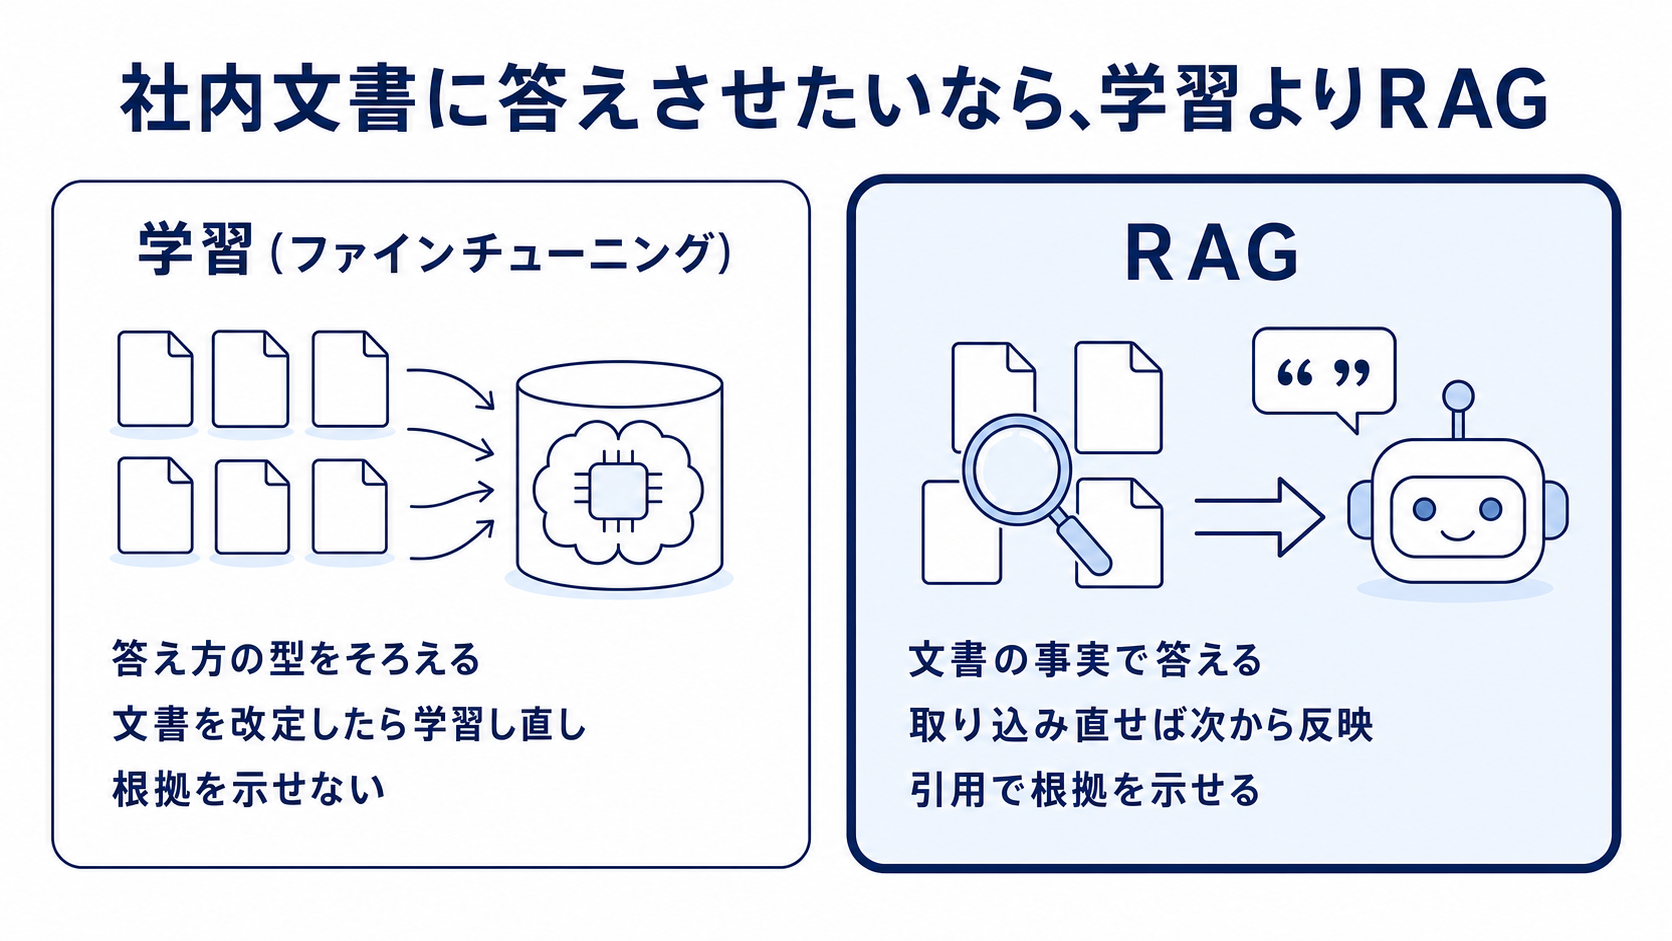
社内文書で答えるAIを作る方法は、大きく2つあります。モデルそのものに社内の文書を覚えさせる学習(ファインチューニング)と、モデルはそのままにして、質問のたびに文書を探して渡すRAGです。
学習(ファインチューニング)でできること、できないこと
学習は、用意した例文や問答をもとにモデルの中身(重み)を調整する方法です。言い回しや答えの形式、専門用語の使い方をそろえるのは得意で、「社内の報告書の書式で答えてほしい」「決まった分類のどれかで返してほしい」といった目的には向いています。
一方で、規程の条文や製品の仕様のような細かい事実を正確に覚えさせ、正しく引き出させるのは得意ではありません。覚えた内容がどの文書から来たのかをモデルが示すことはできず、文書が改定されれば学習し直す必要があります。学習用のデータの準備と、学習を回すための大きな計算機も要ります。
RAGでできること
RAGは、2020年に Facebook AI(当時)などの研究者が発表した論文で広く知られるようになった方法で、モデルの中に覚えた知識と、外から引いてくる文書を組み合わせて答えを作ります(出典: Lewis ほか「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」(2020年))。
比べる点 | 学習(ファインチューニング) | RAG |
向いている目的 | 答え方の型・言い回しをそろえる | 文書に書かれた事実で答える |
文書を改定したとき | 学習し直すまで答えに反映されない | 文書を取り込み直せば次の質問から反映される |
答えの根拠 | どの文書から来たかを示せない | 使った文書と箇所を引用として示せる |
見せてはいけない文書 | 覚えた内容だけを消すのは難しい | 検索の段階で、読める人の文書だけに絞れる |
要るもの | 学習用のデータと、学習を回す計算機 | 文書の整理と、検索の仕組み |
社内の規程やマニュアルは、改定や担当の交代で中身が変わり続けます。答えの根拠を元の文書で確かめられること、文書を直せば答えが変わることを考えると、社内文書で答えるAIの土台はRAGで作るのが向いています。RAGと学習の考え方そのものは、「社内資料で答えるAIの作り方」でも触れています。
学習を足すのはどんなときか
RAGで組んだあとに、答えの中身は合っているのに、言い回しや書式がばらつく、社内の略語を取り違える、といった不満が残ることがあります。そのときに、答え方の型をそろえる目的で学習を足すのは理にかなっています。
順番を逆にして、学習から始めてしまうと、学習用のデータを作る手間をかけたのに、事実の答えは外れたまま、という所で止まりやすくなります。まずRAGで「文書に書いてあることには答えられる」状態を作り、残った不満の種類を見てから学習を考えるほうが、手戻りが少なく済みます。
社内で動かすRAGの部品
ローカルLLMでRAGを組むとき、社内に置くのは文章を作るモデルだけではありません。文書を探すためのモデルや入れ物も含めて、すべてを社内に置かないと、文書の中身が途中で社外に出てしまいます。
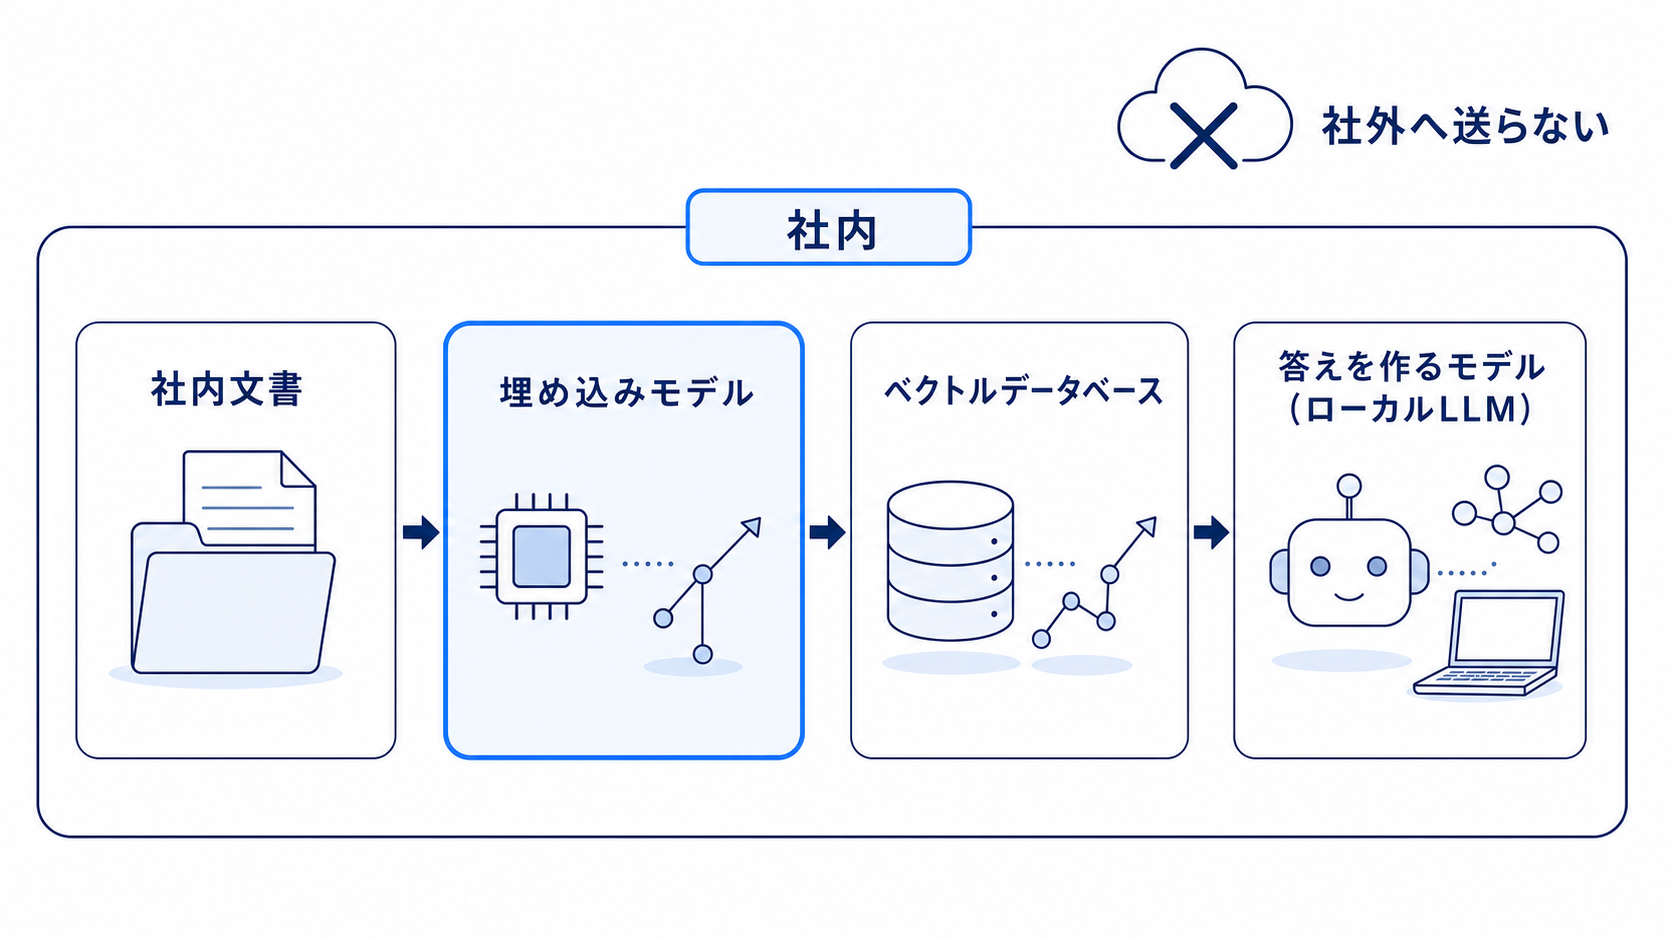
3つのモデル
RAGで使うモデルは、多くの場合2つか3つです。
モデル | 受け持つこと | 社内に置かないとどうなるか |
答えを作るモデル(ローカルLLM) | 渡された文書の箇所をもとに答えの文章を作る | 質問と文書の箇所が社外へ送られる |
埋め込みモデル | 文書と質問を、意味の近さで比べられる数の並び(ベクトル)に変える | 取り込むすべての文書が社外へ送られる |
並べ替えのモデル(使う場合) | 探してきた候補を、質問に近い順に並べ直す | 候補の文書の箇所が社外へ送られる |
見落としやすいのが埋め込みモデルです。答えを作るモデルを社内に置いても、文書をベクトルに変える処理をクラウドのサービスで行えば、取り込むすべての文書がいったん社外へ送られます。「社外に送れない文書を扱うためにローカルLLMにする」のであれば、埋め込みモデルも社内で動かす必要があります。
文書の入れ物と、つなぐ仕組み
モデルのほかに、ベクトルにした文書を入れておく入れ物(ベクトルデータベース)と、質問を受けて検索し、見つけた箇所をモデルに渡す仕組みが要ります。ローカルLLMを動かす道具の中には、埋め込みも作れるものがあり、たとえば Ollama は埋め込みを作る機能を備えています(出典: Ollama の説明書「Embeddings」・2026年11月8日に確認)。
道具をそろえれば試しに動かすところまでは早く進みますが、業務で使うには、文書の取り込み直し、使える人の権限、使われた記録の保管まで含めて組み立てる必要があります。
日本語の社内文書で気をつけること
埋め込みモデルは日本語に対応したものを選ぶ
埋め込みモデルには、英語の文書を中心に作られたものも多く、日本語の文書では意味の近い箇所をうまく探せないことがあります。日本語を含む多くの言語に対応した、商用で使える条件の埋め込みモデルとしては、たとえば次のようなものが公開されています(2026年11月8日に各モデルカードで確認)。
モデル | 公開元の説明 | 使い方の条件 |
BGE-M3 | 100以上の言語に対応し、最大8,192トークンまでの長い文を扱える | MIT ライセンス |
multilingual-e5-large | 多言語に対応。512トークンを超える文は切られる。入力の頭に「query: 」「passage: 」を付ける決まりがある | MIT ライセンス |
出典: BAAI/bge-m3 のモデルカード(Hugging Face)、intfloat/multilingual-e5-large のモデルカード(Hugging Face)
どちらが向くかは、文書の長さや種類によって変わります。モデルカードの説明だけで決めず、自社の文書と実際の質問で探せるかを比べて選ぶのが確実です。当社はこの2つを比べたことはありませんが、相棒AIの試験では、手元の機械で動く埋め込みモデル qwen3-embedding(4b)で、試験用の社内資料7点(339ページ・約15万字)をすべてベクトルにし直しました。答えのある100問で、期待した資料が検索の上位8件に入った率は、ベクトルの検索だけで100%、キーワードと組み合わせた検索で96%、キーワードだけの検索で88%でした(2026年10月・1回の測定)。日本語の文書でも、社内で動かす埋め込みモデルで十分に探し当てられる場合があるということです。
文書の切り方で、探せるかどうかが決まる
RAGでは、文書をそのまま1つの塊として入れるのではなく、数百字ほどの小さな単位に切ってからベクトルにします。この切り方が合っていないと、条文の途中で切れて条件が抜け落ちる、表の見出しと中身が離れて意味が通らなくなる、といったことが起きます。
規程なら条ごと、マニュアルなら見出しごとというように、文書の作りに合わせて切ると探しやすくなります。スキャンしただけの紙の資料や、画像の中の文字は、そのままでは読めないので、文字を起こしてから取り込む必要があります。
答えを作るモデルに渡せる量にも限りがある
答えを作るモデルには、一度に読める文章の長さに上限があり、社内の機械で動かす大きさのモデルでは、クラウドの大きなモデルより短いこともあります。探してきた箇所を全部渡そうとすると上限を超えるので、質問に近い箇所だけを選んで渡す工夫が要ります。並べ替えのモデルを使うのは、この選び方の精度を上げるためです。
相棒AIの試験では、検索はプログラムが行い、答えを作るモデルには上位6ページ(約3,500トークン)だけを渡して1回で答えさせる形(1回呼び)に作り直しました。決まりをまとめたルールブック(11件)を指示に足すと、ルールで決まる自作の16問では正解が9問から13問に増えましたが、108問全体では、条件をそろえて3回ずつ流した平均で92.3問から90.0問に下がりました。社内の機械で動くモデルは長い指示に弱いと見られ、当社はローカルの1回呼びではルールブックを入れない判断をしています(クラウドの Claude で答える形では残しています)。
答えの質は、決まった質問で確かめる
ローカルLLMでRAGを組んだあと、「なんとなく良さそう」で広げると、使い始めてから外れた答えが続き、元の聞き方に戻ってしまいます。答えの質は、決まった質問の一覧で確かめるのが確実です。
1つ目は、実際に社員から出そうな質問と、その正しい答えが書かれている文書の箇所を、30〜50件ほど一覧にすることです。2つ目は、その質問を流し、正しい箇所を探し当てられたか(検索の良し悪し)と、その箇所をもとに正しく答えたか(答えの良し悪し)を分けて見ることです。
分けて見るのは、直す所が違うからです。探し当てられていないなら、文書の切り方や埋め込みモデルを見直します。探し当てているのに答えが外れるなら、答えを作るモデルの大きさや指示の出し方を見直します。この一覧は、モデルを入れ替えたときや文書を増やしたときにも流し直せるので、作っておくと長く使えます。
当社は相棒AIで、試験用の社内資料7点に対して108問(答える100問・答えてはいけない8問)の一覧を作り、AIを使わない文字の照合で合否を付けました(Mac mini M5 Pro・メモリ64GB・Ollama 0.40.0。特に断りの無い数字は1回ずつの測定で、揺れの幅は測っていません)。
答えを作るモデル(1回呼び) | 合格 | 1問の平均時間 |
社内の機械:Qwen3.6 で答え、答えられなかった問だけ Gemma 4 に回す二段 | 94 / 108(87%) | 15秒(最大49秒) |
社内の機械:Qwen3.6 だけ | 59〜66 / 108 | 3〜5秒 |
参考:クラウドの Claude Haiku 5.5 | 102 / 108 | 4.8秒 |
Qwen3.6 が「見当たらない」と返して落ちた問は、渡したページに答えの語がすべて入っていました。検索は当たっているのにモデルが慎重すぎた形で、2段目に別のモデルを置くと、落ちた49問のうち36問を拾えました。答えてはいけない8問は、二段の形で8問とも断れました。一方、図面のように文字の無い資料の問は、社内の機械のモデルでは12問中3〜5問しか答えられず、今の形では向きません。
相棒AIは、答えに使った文書の箇所を引用として示し、答えられなかった質問を残して、足りない文書を見つけられる作りにしています。答えられなかった質問は、一覧に足していく材料にもなります。
ローカルLLMでRAGを組む5つの手順
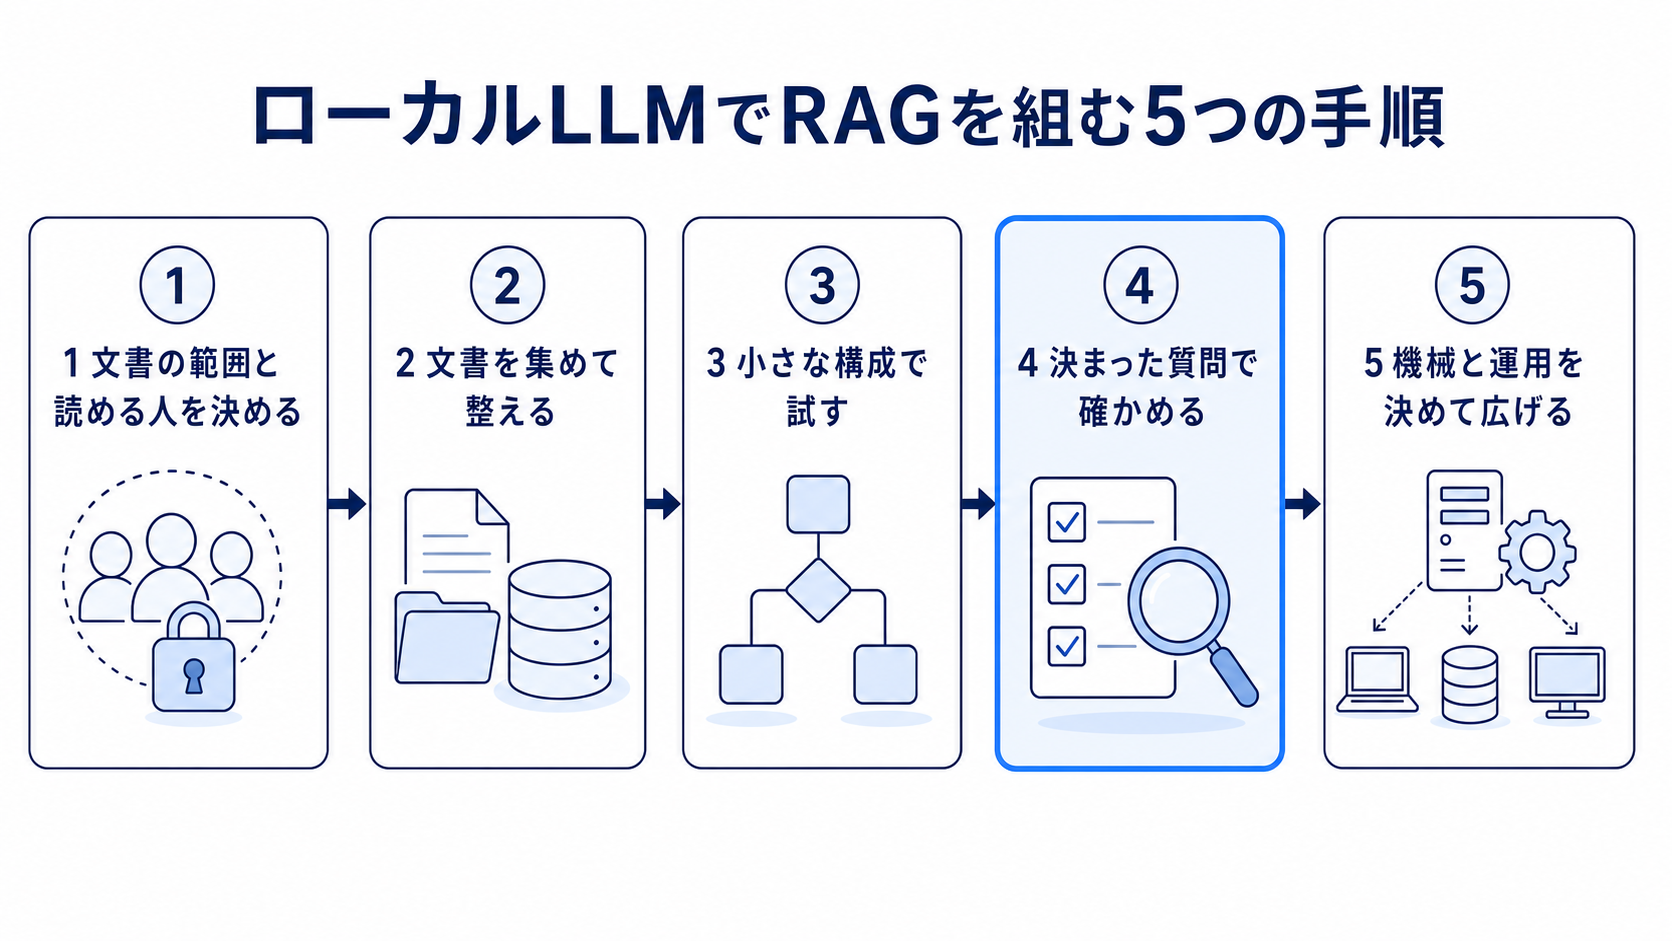
1つ目は、答えさせる文書の範囲と、読める人を決めることです。部署ごとに見せてよい文書が違うなら、その区分も最初に決めます。RAGでは検索の段階で読める人の文書だけに絞れますが、区分が決まっていなければ絞りようがありません。
2つ目は、文書を集めて整えることです。古い版や重複を外し、紙の資料は文字に起こし、文書の作りに合わせて切ります。手間がかかるのはこの段で、モデルの設定より時間を取ることが多くなります。
3つ目は、小さな構成で試すことです。答えを作るモデル、埋め込みモデル、入れ物を手元の機械にそろえ、1つの部署の文書だけで動かします。4つ目は、決まった質問の一覧で答えの質を確かめ、検索と答えのどちらを直すかを見極めることです。
5つ目は、使う人数と文書の量に合わせて機械を決め、文書の取り込み直し、権限、記録の保管、モデルの入れ替えを誰が受け持つかを決めてから広げることです。作ったあとの運用を受け持つ人がいないと、文書が古くなり、答えも少しずつ外れていきます。社内でAIを使うときの決まりは「生成AIの社内ルールの作り方」でまとめています。
すべてを社内に置くかは、文書ごとに決める
ここまで、すべてを社内に置く前提で書いてきましたが、社内のすべての文書が社外に送れないわけではありません。社外に送ってよい文書は、法人向けの契約で入力を学習に使わない設定のクラウドの生成AIで扱い、送れない文書だけを社内のRAGで扱う、という分け方もできます。学習に使わせない設定の考え方は「生成AIに機密情報を学習させない方法」で書いています。
当社が開発・運用している相棒AIは、回答の生成に Anthropic の Claude、検索の補助に OpenAI の埋め込みモデルと、クラウドのモデルを使って組んでいます。社外に送ってよい文書であれば、クラウドのモデルで組むほうが、機械の用意や保守の手間がかからず、答えの質も高いモデルを使えるというのが、自社で運用している立場からの見方です。上の試験でも、社内の機械の二段は108問中94問、クラウドの Claude Haiku は102問と、答えの質と速さにはまだ差がありました。社外に送れない文書だけを社内で扱う分け方が、いまは向いていると考えています。
まとめ
- 社内文書の事実で答えさせたいなら、学習(ファインチューニング)よりRAGが向く
- 学習は、答え方の型や言い回しをそろえたいときに、RAGの後から足す
- 社外に文書を出さないなら、答えを作るモデルだけでなく埋め込みモデルも社内に置く
- 日本語の文書は、埋め込みモデルの選び方と文書の切り方で探せるかが決まる
- 答えの質は、決まった質問の一覧で、検索と答えを分けて確かめる
ローカルLLMでRAGを考え始めたら、まず社外に送れない文書がどれかを決め、1つの部署の文書と30件ほどの質問で小さく試すところから始めるのがおすすめです。社外に送ってよい文書が中心なら、当社の相棒AIで、引用つきで答える社内AIをすぐに始められます。
よくある質問
- ローカルLLMに社内の文書を学習させるには、どうすればよいですか。
- 社内文書の事実で答えさせたいなら、学習(ファインチューニング)より、質問のたびに文書を探して渡すRAGが向いています。RAGなら文書を取り込み直すだけで答えが変わり、使った文書を引用として示せます。
- RAGとファインチューニングの違いは何ですか。
- ファインチューニングはモデルの中身を調整して、答え方の型や言い回しをそろえる方法です。RAGはモデルはそのままにして、質問のたびに社内文書から関係する箇所を探して渡し、その箇所をもとに答えさせる方法です。
- ローカルLLMでRAGを組むとき、社内に置くものは何ですか。
- 答えを作るモデルに加えて、文書をベクトルに変える埋め込みモデルと、ベクトルを入れておくデータベースも社内に置きます。埋め込みをクラウドで行うと、取り込むすべての文書が社外へ送られます。
- 日本語の文書に使える埋め込みモデルはありますか。
- 多言語に対応した BGE-M3 や multilingual-e5-large などが、MIT ライセンスで公開されています(2026年11月8日に各モデルカードで確認)。自社の文書と質問で探せるかを比べて選ぶのが確実です。
- ローカルLLMのRAGの精度は、どう確かめればよいですか。
- 社員から出そうな質問と、答えが書かれた文書の箇所を30〜50件ほど一覧にし、正しい箇所を探せたかと、正しく答えたかを分けて見ます。探せていなければ文書の切り方や埋め込み、答えが外れるならモデルや指示を見直します。
次に読む記事
ローカルLLMに必要なスペックと機材の費用|GPU・VRAM・Mac miniの選び方と、人数で変わる目安
記事を読むこの記事を書いた人
株式会社デイワン 代表取締役 月森 隼人
不動産コンサルタント、注文住宅やマンションなどの企画営業を経験し、大手広告代理店のデジタル部署にて、Web領域でのブランディングややディレクションなど上流から幅広く担当。