ローカルLLMとは?できることとメリット・デメリット
ローカルLLMとは、公開されている言語モデルを自社のパソコンやサーバーで動かす使い方です。クラウドの生成AIとの違い、できることと使い道、メリットとデメリット、向く場面、必要な機械と運用、導入の進め方を、AIを自社で開発・運用する立場から解説します。
生成AIを業務に使いたいものの、設計図や顧客の情報、まだ発表していない計画のように、社外のサービスへ送れない情報が多いため、話が先に進まない会社があります。そこで候補に挙がるのが、自社のサーバーや閉じたネットワークの中でAIを動かす「ローカルLLM」です。
ただ、「社内に置けば安全」という理由だけで進めると、機械をそろえたあとで、思ったほど答えが良くない、直せる人がいない、という所で止まりやすくなります。この記事では、ローカルLLMとは何か、できることと使い道、メリットとデメリット、向く場面と向かない場面、必要な機械と運用、導入の進め方を順に整理します。
先に決めるべきなのは、「何を外に出せないか」です。外に出せない情報の範囲が決まれば、すべてを社内に置くのか、その部分だけを社内に置き、ほかはクラウドの生成AIを使うのかが決まり、機械の大きさや運用の重さも見積もれるようになります。
ローカルLLMとは。クラウドの生成AIとの違い
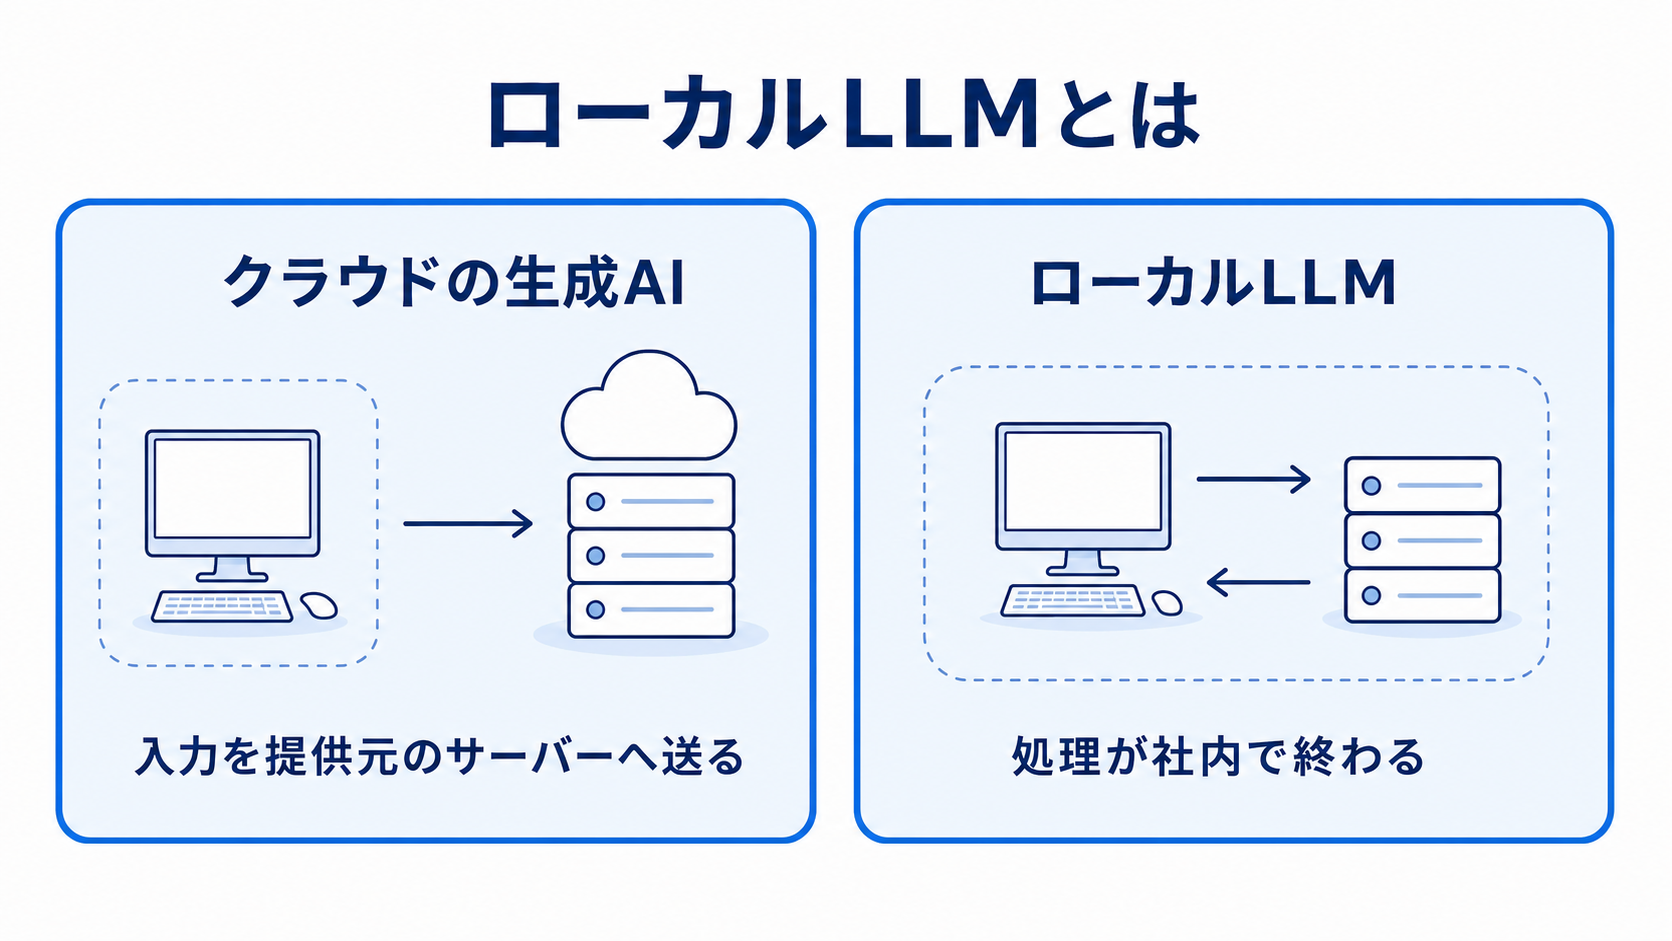
ローカルLLMは、公開されている言語モデル(重みが配られているモデル)を、自社のパソコンやサーバー、データセンターの中で動かす使い方です。ChatGPT や Claude のようなクラウドの生成AIでは、入力した文章が提供元のサーバーへ送られて処理されますが、ローカルLLMでは処理が社内で終わります。
比べる点 | クラウドの生成AI | ローカルLLM |
データの行き先 | 提供元のサーバーへ送る | 社内で処理が終わる |
答えの質 | 提供元の最新の大きなモデルを使える | 社内の機械で動く大きさのモデルに限られる |
始めるまで | 契約すればすぐ使える | 機械の用意と組み立てが要る |
費用のかかり方 | 使った量に応じて払う | 機械を先に買い、電気代と保守がかかる |
更新・保守 | 提供元が行う | 自社(か委託先)が行う |
クラウドの生成AIでも、法人向けの契約では入力を学習に使わない設定が選べることが多く、外に出せない情報の多くはそれで足りる場合があります。学習に使われない設定の考え方は、生成AIに機密情報を学習させない方法で詳しく書いています。ローカルLLMが要るのは、学習に使われないだけでは足りず、社外へ送ること自体が取り決めや社内の規程で許されない情報を扱うときです。
社内の機械で動かせる理由
言語モデルの中身は、学習で決まった膨大な数の値(重み)です。クラウドの生成AIではこの重みを提供元が持ったまま外に出しませんが、ローカルLLMで使うモデルは、提供元が重みそのものを配っています。配られた重みを自社の機械に置き、質問を入れて答えを出させる(推論させる)のがローカルLLMの仕組みです。
重みは大きいと数百GBになりますが、値の細かさを落として小さくする「量子化」という手法で、手元の機械に収まる大きさにして動かすことが広く行われています。たとえば OpenAI の gpt-oss は、量子化した形で配られているため、大きい方の gpt-oss-120b(全体で1,170億の値のうち、1回の計算に使うのは51億)でも80GBのGPU 1枚に収まると説明されています(出典: OpenAI gpt-oss-120b のモデルカード(Hugging Face)・2026年11月8日に確認)。
なぜ今、ローカルLLMが話題になるのか
理由は大きく2つあります。1つは、配られるモデルの質が上がり、社内の機械で動く大きさでも、要約や文書の下書き、決まった資料を読んで答えるといった業務に使える場面が増えたことです。もう1つは、生成AIを業務で使う会社が増えたことで、取引先との取り決めや社内の規程に照らして、どの情報なら社外のサービスへ送ってよいかを決める必要に迫られる会社が増えたことです。
どのモデルを使うかは、日本語の出来、動かすのに要る機械の大きさ、使い方の条件(ライセンス)の3つで絞ります。モデルの名前は数か月で入れ替わるので、名前から入るより、この3つの軸を先に決めておく方が、選び直しになったときにも迷いにくくなります。2026年11月時点の候補は、ローカルLLMのおすすめモデル比較で比べています。
ローカルLLMでできること・使い道
ローカルLLMでできることは、文章を読んで書くという点では、クラウドの生成AIと変わりません。違うのは、外に出せない情報を入れられることと、ネットにつながない環境でも動かせることです。業務での使い道は、この2つが効く所を選ぶと決めやすくなります。
使い道 | ローカルLLMにする理由 |
社内の資料を読ませて答えさせる(社内の問い合わせ・手順の確認) | 規程・設計資料・顧客の記録など、社外に送れない資料を読ませられる |
議事録や報告書の要約・下書き | 発表前の計画や人事の話など、外に出せない内容を含む |
契約書や仕様書の確認の下準備 | 取引先との取り決めで、社外のサービスに送れない |
工場や研究所など、ネットにつながない現場での手順の確認 | 外とつながない環境でも動く |
プログラムのコードの説明・下書き | 自社のコードを社外に出せない |
一方で、最新の情報を調べる、難しい推論を何段も重ねる、といった使い方は、社内の機械で動く大きさのモデルでは答えの質に差が出やすい所です。こうした作業は、扱う情報が社外に送ってよいものなら、クラウドの生成AIに任せる方が向いています。
当社がローカルLLMを試して得た結論も、ローカルLLMは物知りではなく、渡した資料を処理する道具として使うというものです。モデル単体の知識は学習した時点で止まり、小さいモデルほど知識が薄く、もっともらしい作り話もします。そのため「知っていることを聞く」使い方より、「渡した資料を訳す・まとめる・抜き出す」使い方に向き、ネットで調べた結果を使わせたいときは、質問が社外の検索サービスへ送られる点を踏まえて決める必要があります。
ローカルLLMのメリットとデメリット
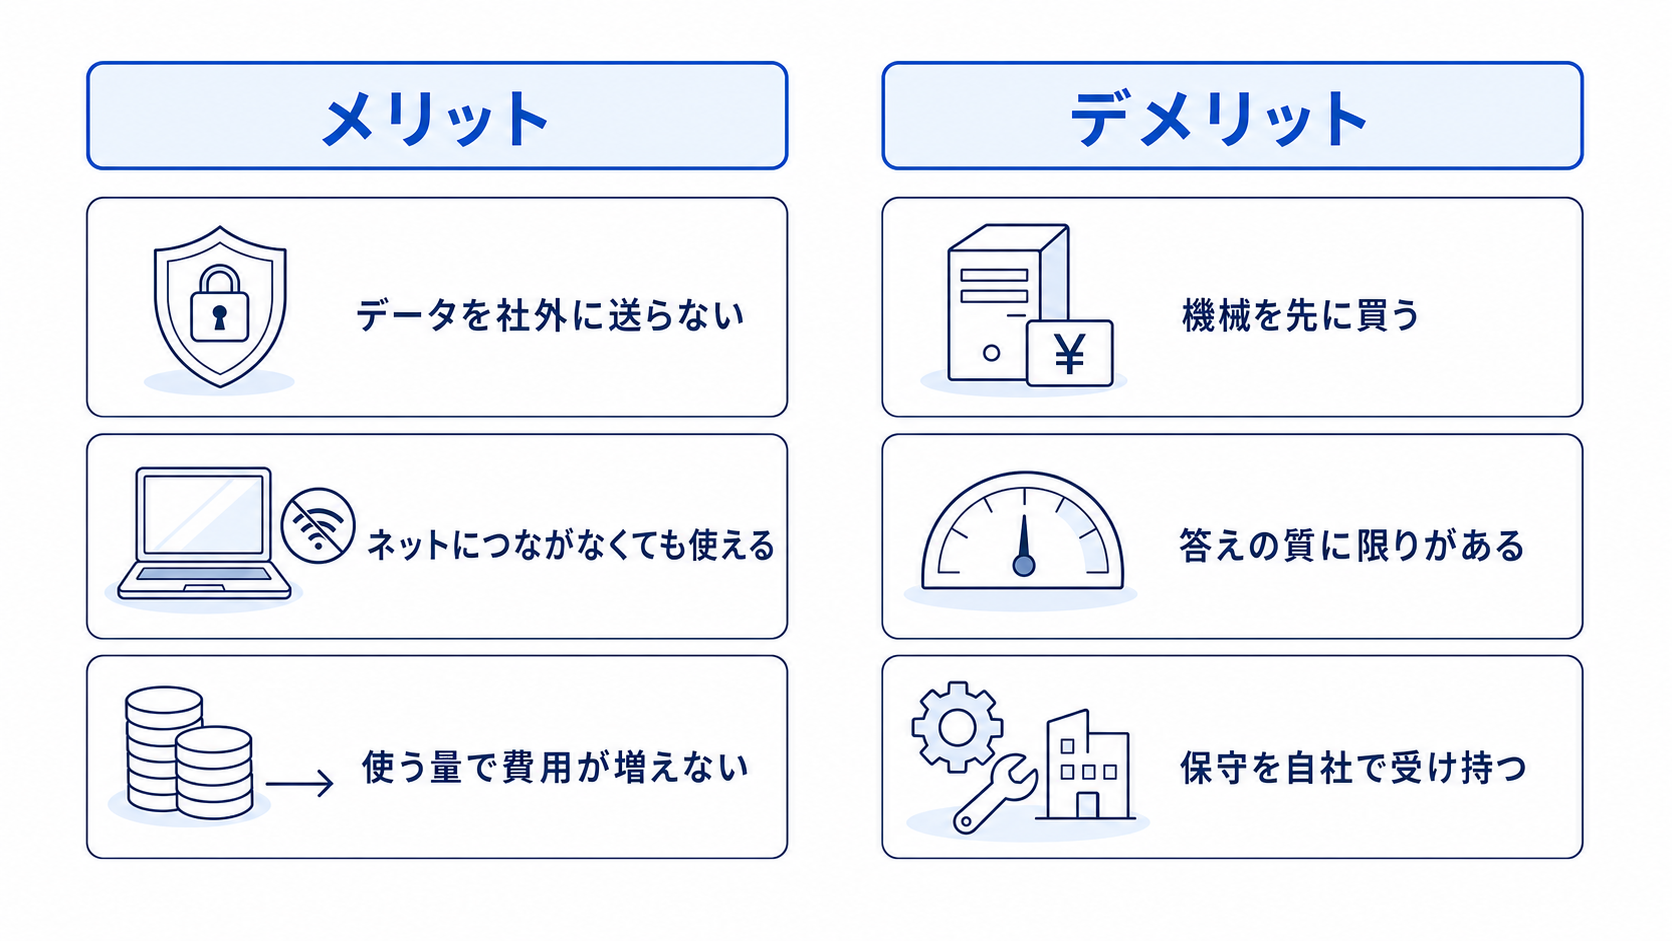
メリットの1つ目は、データを社外に送らないことです。社外へ送ること自体が許されない情報でも、生成AIで扱えるようになります。2つ目は、ネットにつながなくても使えることで、外とつながない工場や研究の環境にも置けます。3つ目は、使う量で費用が増えないことです。機械を買ったあとは、使う回数が増えても、かかるのは電気代と保守が中心になります。
デメリットの1つ目は、機械を先に買う必要があることです。使う人数や読ませる資料の長さによっては、GPUを積んだサーバーが要り、始める前の負担が大きくなります。2つ目は、答えの質に限りがあることで、社内の機械で動く大きさのモデルは、クラウドの最新の大きなモデルと比べると、難しい推論や長い文章で差が出ることがあります。3つ目は、保守を自社で受け持つことです。モデルの入れ替え、故障への対応、使える人の権限の管理を、自社か委託先が続けることになります。
メリット | デメリット |
データを社外に送らない | 機械を先に買う |
ネットにつながなくても使える | 答えの質に限りがある |
使う量で費用が増えない | 保守を自社で受け持つ |
メリットとデメリットのどちらが重いかは、扱う情報で決まります。外に出せない情報が業務の中心なら、デメリットを引き受けてでもローカルLLMにする意味があり、そうでなければ、学習に使われない設定のクラウドの生成AIで足りることが多くなります。
ローカルLLMが向く場面、向かない場面
向くかどうかは、会社全体ではなく、扱うデータの種類ごとに考えると判断しやすくなります。社外へ送れない情報を扱う作業はローカルLLMに、それ以外はクラウドの生成AIに、というように分けて使う形も取れます。
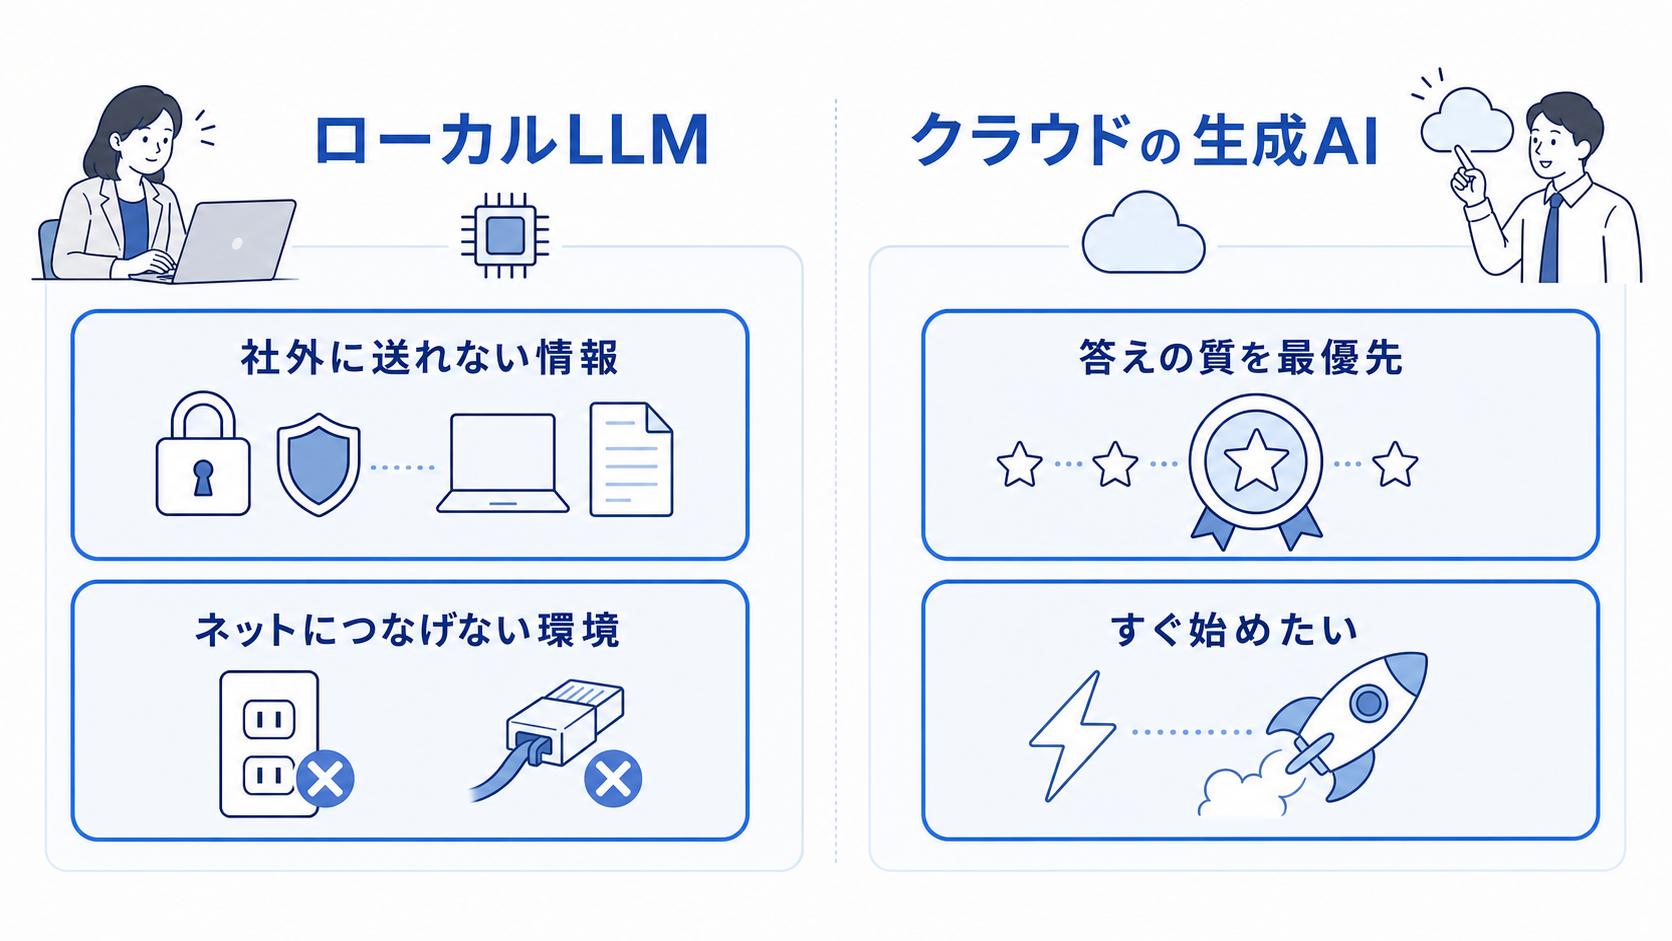
ローカルLLMが向く場面 | クラウドの生成AIが向く場面 |
取引先との取り決めで社外に送れない資料を扱う | 一般的な文書の下書きや要約 |
ネットにつながない工場や研究の環境で使う | 難しい推論や長い文章で、答えの質を最優先したい |
社内の決まった資料だけを読ませて答えさせる | 小さく試して、効き目を早く確かめたい |
使う量が多く、使った量で払う形だと負担が大きい | 機械を持たず、保守の人手を割けない |
社内の資料を読ませて答えさせる仕組み(RAG)は、ローカルLLMでも組めます。ただ、どの資料を読ませるか、答えられなかった質問をどう拾って資料を直すかといった肝心な所は、モデルを社内に置くかどうかとは別に決める必要があります。仕組みの作り方は社内資料で答えるAIの作り方にまとめました。ローカルLLMで組むときの仕組みは、ローカルLLMでRAGを組むで書いています。
当社が自社で開発・運用している相棒AIは、回答の生成に Anthropic の Claude、検索の補助に OpenAI の埋め込みモデルと、クラウドのモデルを使っています。社内の資料で答えるAIであっても、扱う資料が社外に送ってよいものであれば、クラウドのモデルで十分に組めるというのが、自社で運用している立場からの見方です。
社内に置くために必要な機械と運用
機械の目安
必要な機械は、動かすモデルの大きさでほぼ決まります。たとえば OpenAI が2025年に公開したモデル gpt-oss は、公式の説明によると、大きい方の gpt-oss-120b は80GBのGPU 1枚で、小さい方の gpt-oss-20b は16GBのメモリで動くように作られています(出典: OpenAI gpt-oss-120b のモデルカード(Hugging Face)、Hugging Face による紹介)。
この数字は、1人が動かして答えが返る最低限の目安です。社内の何十人が同時に使う、長い資料を一度に読ませる、といった使い方では、必要な機械はさらに大きくなります。機械を買う前に、同時に使う人数と、1回に読ませる資料の長さを決めておくと、買いすぎも足りなさも避けやすくなります。人数ごとの機械と費用の目安は、ローカルLLMに必要なスペックと機材の費用にまとめています。
決めておくこと | 機械への影響 |
動かすモデルの大きさ | GPUのメモリの量 |
同時に使う人数 | GPUの枚数・台数 |
1回に読ませる資料の長さ | メモリの量・答えが返るまでの時間 |
止まってよい時間 | 予備の機械を置くか |
置いたあとに要る運用
ローカルLLMでは、クラウドの生成AIなら提供元が受け持つ作業を、自社か委託先が受け持つことになります。新しいモデルが出たときの入れ替え、機械や部品の故障への対応、使える人の権限の管理、利用の記録の保管などで、作ったあとも直し続ける人がいないと、少しずつ古く使いにくくなっていきます。
作った人が異動して誰も触れなくなる、という止まり方は、ローカルLLMに限らず社内で作った仕組みによく起きます。外注先や前任者が作った仕組みを受け継ぐときの考え方は、他社が作ったシステムの引き継ぎで書いています。
ローカルLLM導入の進め方
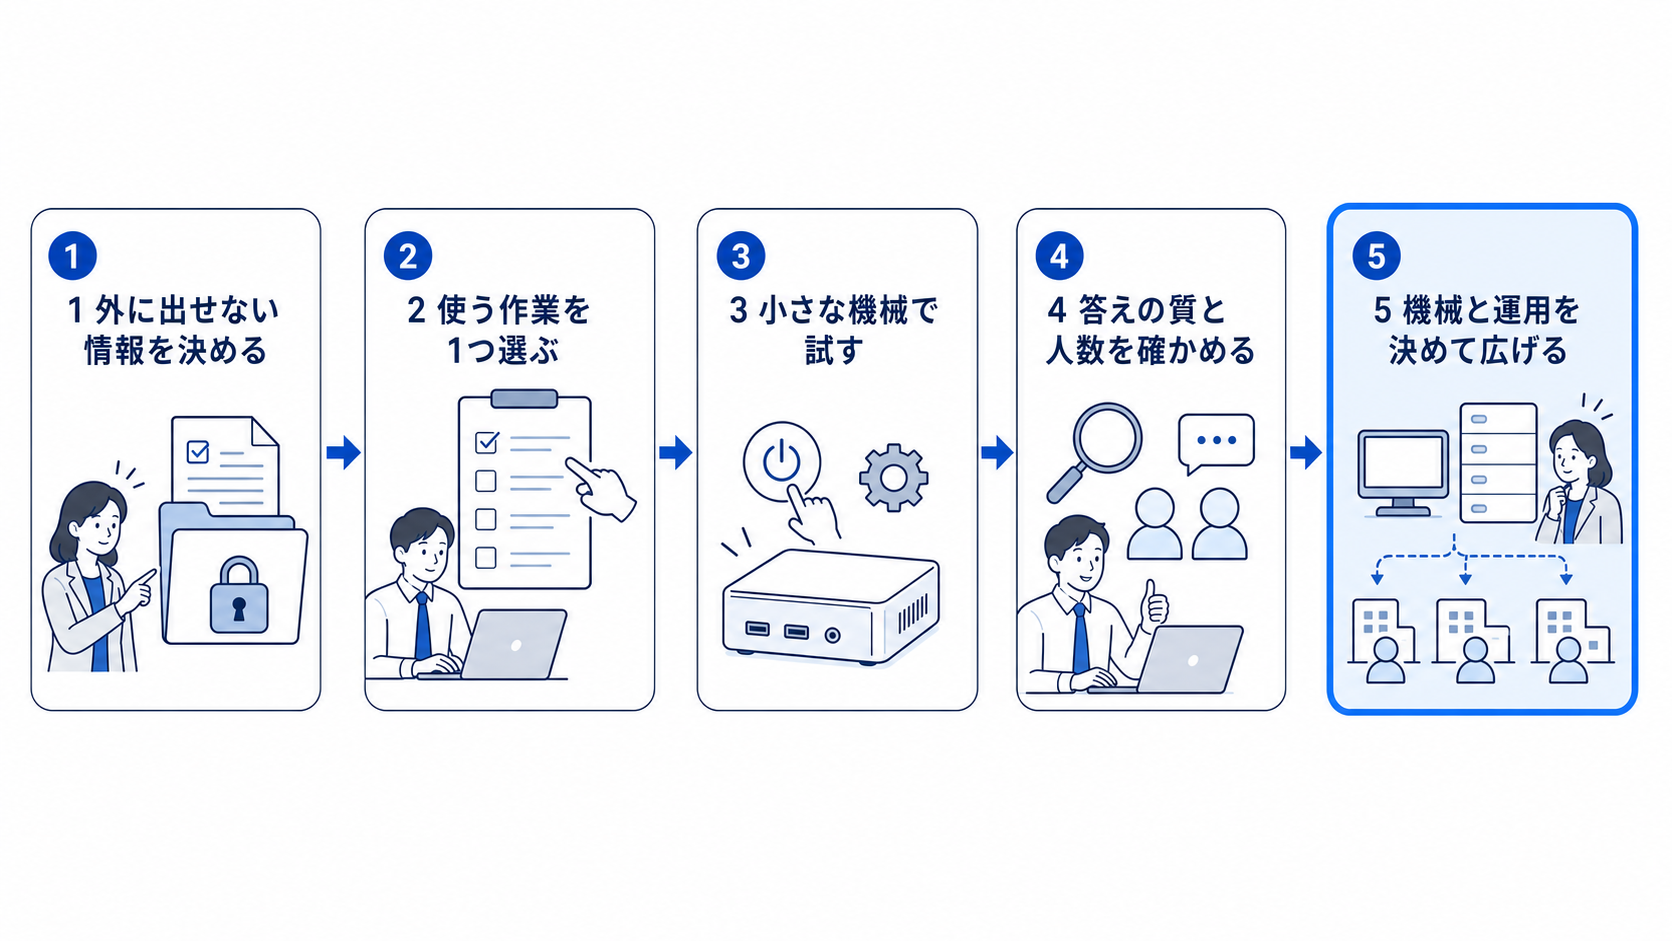
1つ目は、外に出せない情報の範囲を決めることです。情報システムの担当だけで決めず、取引先との取り決めや社内の規程を持つ部署と一緒に確かめると、あとで範囲が変わって作り直す事態を避けられます。社員が生成AIに何を入れてよいかの決まりは、生成AIの社内ルールの作り方にひな型つきでまとめています。
2つ目と3つ目は、使う作業を1つに絞り、手元のパソコンや小さなサーバーで試すことです。小さなモデルで、実際の資料を使って答えの質を見れば、そのモデルで足りるのか、大きなモデルが要るのかの見当が付きます。試すときの道具と手順は、ローカルLLMの構築手順にまとめています。
4つ目では、試した結果をもとに、答えの質が業務に足りるか、同時に何人が使うかを確かめます。最後に、機械の大きさと、誰がどう保守するかを決めてから広げます。試したまま止まってしまったAIを動かし直すときの考え方は、PoC止まりのAIを立て直すにはにまとめています。
費用の考え方は、機械を買うかどうかで大きく変わります。AI導入の費用の見方はAI導入の費用で整理しました。
ローカルLLM導入で気をつけること
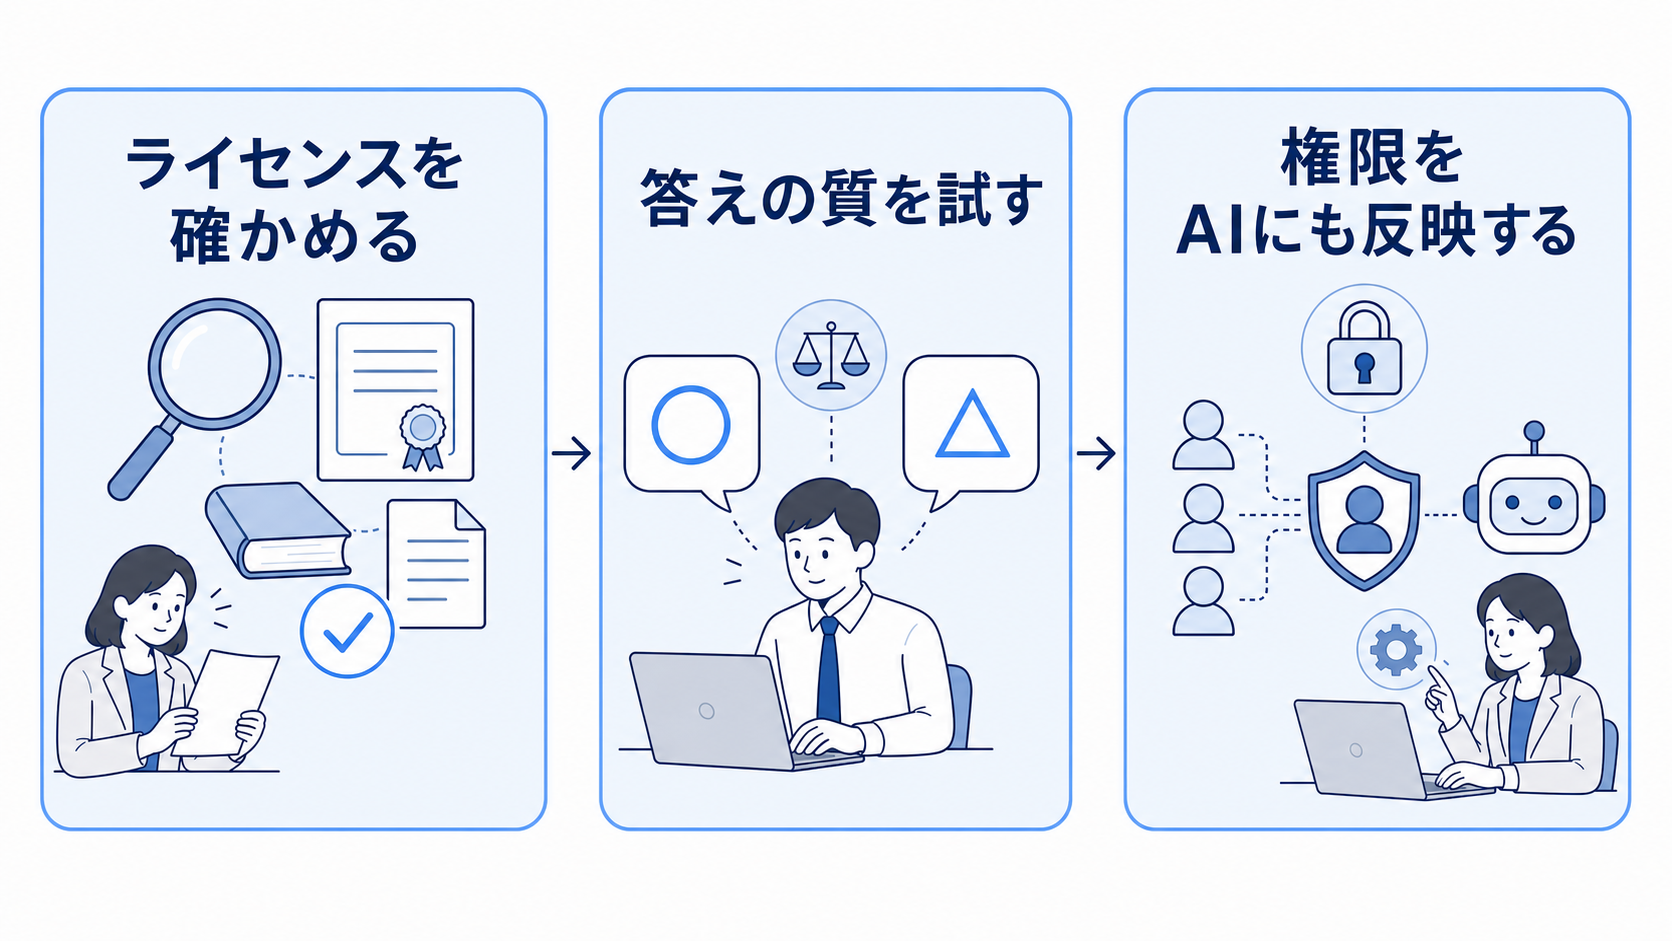
1つ目は、モデルの使い方の条件です。公開されているモデルにも、それぞれ使い方の条件(ライセンス)があり、商用で使えるか、改変してよいかはモデルごとに違います。gpt-oss は Apache 2.0 のライセンスで公開されていますが(出典: 上のモデルカード)、ほかのモデルを使うときも、必ず提供元の条件を確かめてください。
2つ目は、答えの質への期待です。社内の機械で動く大きさのモデルは、クラウドの最新の大きなモデルと比べると、難しい推論や長い文章で差が出ることがあります。実際の資料と質問で試し、業務に足りるかを確かめてから広げると、導入後の「思ったほどではない」を減らせます。
当社では、製造業のお客様の、英語・ドイツ語を含む取扱説明書9本を日本語に整えさせる作業で、ローカルLLMとクラウドの Claude Sonnet を、同じ指示・同じ採点で比べました(各モデル1回ずつの測定)。2026年9月に MacBook Pro(M3 Pro・メモリ36GB)で試した Qwen2.5 7B・14B と Qwen3 8B では、部品表の列を取り違える、行を黙って落とす、部品名を誤訳するといった、発注を誤らせる種類の誤りが出ました。速さも足りず、原本全体を整えるには、一番速い7Bでも休まず動かして52日、14Bでは102日かかる見込みでした。
2026年10月に Mac mini(M5 Pro・メモリ64GB、Ollama 0.40.0)で新しいモデルを試すと、原文の型番が訳文に残った割合は、9月に測った Sonnet の0.85に対し Qwen3.6 35B-A3B が0.83、Qwen3.8 27B が0.94と、数字の上では並ぶものも出ました。それでも、位置番号を原文に無いものに書き換える、長い部品表の行を約3分の2落とす、考え続けて出力が0字になるといった失敗が、どのモデルにも1つずつ残りました。一番よかったのは、モデルには日本語の本文だけを書かせ、訳文の型番と数値をプログラムで原文と照合し、落ちた所だけをやり直させる試作で、3回目の結果は、日本語の本文で数えた残った割合は0.99(同じ数え方の Sonnet は0.83)、人が確かめる塊は54のうち5でした。値の正しさが要る作業では、モデルを替えるより、原文と機械で照合する仕組みを後ろに置く方が効きます。
3つ目は、社内に置いても情報の扱いの決まりは要るという点です。社内で処理が終わっても、AIが誰でも見られる形で答えれば、本来は見られない人に情報が届いてしまいます。誰がどの資料を読めるかという権限を、AIの答えにも反映させる設計が必要です。
まとめ
- ローカルLLMは、配られている言語モデルを社内の機械で動かし、外に出せない情報を社内で処理するための選択肢
- できることはクラウドの生成AIと同じく文章を読んで書くことで、違いは外に出せない情報を入れられることと、ネットにつながなくても動くこと
- メリットは社外に送らない・オフラインで使える・使う量で費用が増えないこと、デメリットは機械の先払い・答えの質の限り・自社での保守
- 先に「何を外に出せないか」を決めると、置く範囲と機械の大きさが決まり、学習に使われない設定のクラウドの生成AIで足りる場面も見えてくる
- 置いたあとの更新・故障対応・権限の管理を受け持つ人を先に決める
ローカルLLMを考え始めたら、まず社内で外に出せない情報の一覧を作り、それを扱う作業を1つ選んで小さく試すところから始めるのがおすすめです。当社のAIソリューション開発では、外に出せない情報を扱うときに、社内のサーバーで動くAIで作ることもできます。扱うデータの範囲は、ご相談のときに一緒に決めます。
よくある質問
- ローカルLLMとは何ですか。
- 公開されている言語モデル(重みが配られているモデル)を、自社のパソコンやサーバーの中で動かす使い方です。入力した文章が社外へ送られず、処理が社内で終わります。
- ローカルLLMでできることは何ですか。
- 文章を読んで書くことはクラウドの生成AIと同じです。社内の資料を読ませて答えさせる、議事録や報告書を要約する、ネットにつながない現場で手順を確かめる、といった使い道で、外に出せない情報を扱えるのが違いです。
- ローカルLLMのメリットとデメリットは何ですか。
- メリットは、データを社外に送らない、ネットにつながなくても使える、使う量で費用が増えないことです。デメリットは、機械を先に買う、答えの質に限りがある、保守を自社で受け持つことです。
- ローカルLLMにはどのくらいの機械が要りますか。
- 動かすモデルの大きさで決まります。公式の説明では、gpt-oss-20b は16GBのメモリ、gpt-oss-120b は80GBのGPU 1枚で動くように作られています。同時に使う人数が増えると、さらに大きな機械が要ります。
- 機密情報を扱うなら、必ずローカルLLMにすべきですか。
- 必ずではありません。法人向けの契約で入力を学習に使わない設定が選べるクラウドの生成AIで足りる場合もあります。社外へ送ること自体が許されない情報を扱うときに、ローカルLLMを考えます。
次に読む記事
社内問い合わせを効率化する手順と、資料で答えるものの決め方
記事を読むこの記事を書いた人
株式会社デイワン 代表取締役 月森 隼人
不動産コンサルタント、注文住宅やマンションなどの企画営業を経験し、大手広告代理店のデジタル部署にて、Web領域でのブランディングややディレクションなど上流から幅広く担当。