ChatGPT・生成AIの情報漏洩はなぜ起きる?5つの経路とプラン別の扱い、会社でできる対策
ChatGPTなど生成AIの情報漏洩が起きる5つの経路(入力・学習・共有リンク・アカウント・つないだ先)と、実際に起きたこと、OpenAIの公式の記述によるプラン別のデータの扱い、個人情報保護委員会の注意喚起、会社でできる対策を、AIを自社で組む立場から解説します。
目次
1.ChatGPTの情報漏洩は「5つの経路」で起きる
1-1.1. 入力した内容が社外のサーバーに渡る
1-2.2. 学習に使われる
1-3.3. 共有リンクが公開される
1-4.4. アカウントが乗っ取られる
1-5.5. つないだ先のサービスへ渡る
2.実際に起きたこと
3.プラン別のデータの扱い(OpenAIの公式の記述)
4.個人情報を入れるときに個人情報保護委員会が求めること
5.会社でできる対策
5-1.1. 契約の形を決める
5-2.2. 設定をそろえる
5-3.3. 社内ルールで「入れてよい情報」を決める
5-4.4. つなぐ先を確かめる
6.AIを自社で組む立場から見た「つなぐ先」の確かめ方
7.まとめ|漏洩は経路ごとに塞ぐ
社員がChatGPTを仕事で使い始めていると聞いて、顧客の情報や社内の数字が外に漏れていないかと心配になった方は多いのではないでしょうか。「入力した内容はAIに学習される」「学習をオフにすれば大丈夫」といった話をよく耳にしますが、どこまで本当で、会社として何を決めればよいのかは、なかなか見えてきません。
困るのは、漏れたかどうかを会社があとから確かめられないことです。社員が個人のアカウントで無料のサービスを使っていると、何をどこに入れたのかを会社は知りようがなく、問い合わせを受けても説明できません。
生成AIの情報漏洩は「学習」だけの話ではなく、入力・学習・共有リンク・アカウント・つないだ先の5つの経路で起きます。経路ごとに塞ぎ方が違うため、契約の形と設定、社内ルール、つなぐ先の確かめの4つを組み合わせて決めるのが近道です。この記事では、5つの経路と実際に起きたこと、OpenAIの公式の記述によるプラン別の扱い、個人情報保護委員会の注意喚起、会社でできる対策を順に説明します。
ChatGPTの情報漏洩は「5つの経路」で起きる
情報漏洩というと、入力した内容がAIに覚えられて他人の答えに出てくる場面を思い浮かべがちですが、それは経路の1つにすぎません。セキュリティの団体OWASPがまとめた大規模言語モデルの主なリスクの一覧(OWASP Top 10 for LLM Applications 2025)でも、「機密情報の漏えい(LLM02:2025 Sensitive Information Disclosure)」は、モデルそのものとそれを使う仕組みの両方にかかわるものとして挙げられています。
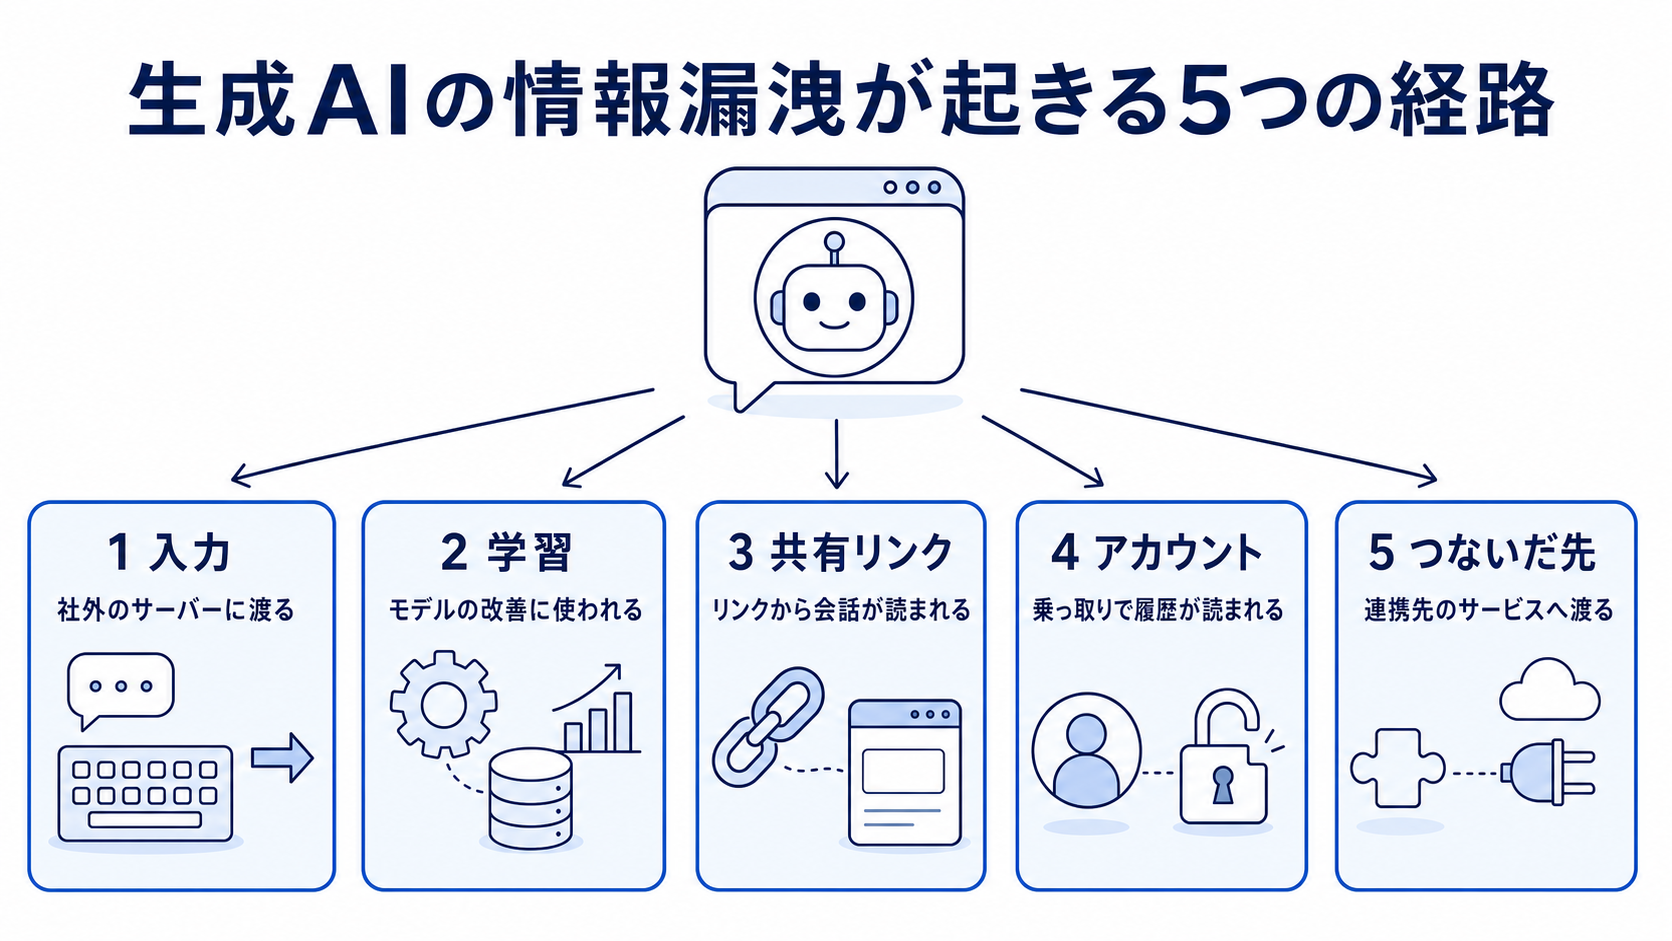
1. 入力した内容が社外のサーバーに渡る
クラウドの生成AIに入力した文章や添付したファイルは、提供元のサーバーへ送られて処理されます。学習に使われない設定であっても、社外へ送ったこと自体は変わらないため、契約や社内の決まりで社外に出してはいけない情報は、この時点で扱いを誤ったことになります。
2. 学習に使われる
サービスや設定によっては、入力した内容がモデルの改善に使われます。学習に使われた内容がそのまま他人の答えに出てくるとは限りませんが、どこにどう残るかを会社が管理できなくなる点が問題です。
3. 共有リンクが公開される
ChatGPTには、会話をリンクで人に見せる機能があります。リンクを知っていれば誰でも見られるため、社外の人に送ったリンクが転送されたり、どこかに貼られたりすると、会話の中身がそのまま読まれます。
4. アカウントが乗っ取られる
パスワードの使い回しなどでアカウントに入られると、過去の会話の履歴がまとめて読まれます。履歴には、仕事で入力した資料や下書きがそのまま残っていることが多く、1つのアカウントから多くの情報が出ていきます。
5. つないだ先のサービスへ渡る
最近の生成AIは、メールやファイル置き場、社内のシステムとつないで使えるようになっています。つないだ先のサービスや、AIを組み込んだ外部のツールがデータをどう扱うかは、生成AIの本体とは別の契約で決まるため、本体の設定だけを見ていると見落とします。
実際に起きたこと
生成AIの漏洩は、利用者の操作だけでなく、提供元の不具合でも起きています。
1つ目は、OpenAIが公表した2023年3月20日の障害です。OpenAIの説明(March 20 ChatGPT outage: Here's what happened)によると、外部のソフトウェアの不具合により、一部の利用者に他人の会話の履歴の題が見える状態になり、特定の9時間の間に利用していたChatGPT Plusの契約者の1.2%について、名前やメールアドレス、カードの下4桁などの支払いにかかわる情報が他人に見えた可能性があったとされています(カード番号の全体は出ていないと説明されています)。
2つ目は、2025年の共有リンクの件です。共有リンクに「検索エンジンで見つけられるようにする」という選択肢があり、これを選んだ会話がGoogleの検索結果に出ていたことが報じられ、OpenAIは2025年7月末から8月初めにかけてこの選択肢を取り下げました。利用者が自分で選んだ設定でも、意味を分からずに選べば会話が公開されるという例です。
どちらも、学習の設定をオフにしていても防げなかったものです。経路ごとに塞ぐ必要があるのは、このためです。
プラン別のデータの扱い(OpenAIの公式の記述)
ChatGPTは、個人向けのプランと、会社で契約する法人向けのプラン、開発者がシステムに組み込むためのAPIで、入力した内容の扱いが違います。OpenAIの公式のヘルプと開発者向けの説明(2026年11月時点)に書かれている範囲をまとめると、次のとおりです。
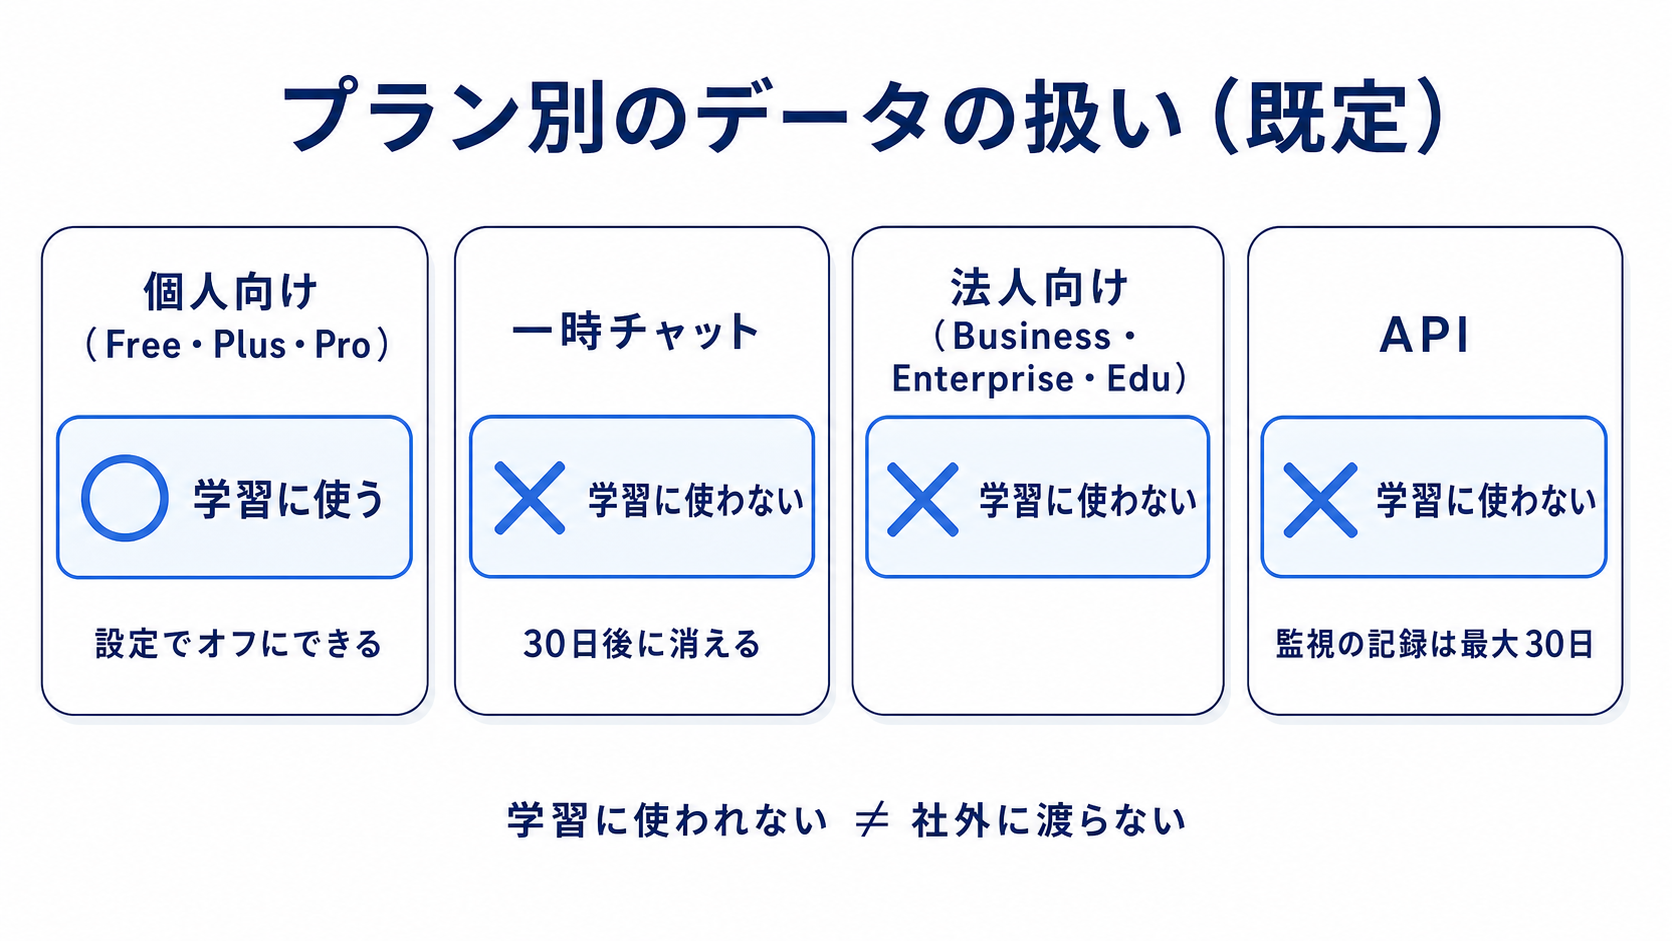
使い方 | 学習への利用(既定) | 主な記述 |
個人向け(Free・Plus・Pro) | 利用する(設定でオフにできる) | 設定の「すべての人のためにモデルを改善する」をオフにすると、通常の会話は学習に使われない |
個人向けの一時チャット | 利用しない | 履歴に残らず、30日後に消える。ただし保存すると通常の会話として扱われる |
法人向け(Business・Enterprise・Edu) | 利用しない | ワークスペースのデータは既定で学習に使われない |
API | 利用しない | 2023年3月1日以降、APIに送ったデータは学習に使われない。不正利用の監視の記録は既定で最大30日残る |
ここで大事なのは、「学習に使われない」と「社外に渡らない」は別のことだという点です。APIでも、不正利用の監視の記録が既定で最大30日残ると説明されており、法人向けのプランでも、入力した内容は提供元のサーバーで処理されます。また、個人向けで学習をオフにしても、会社が社員の設定を確かめる手段はありません。会社として管理したいなら、会社で契約した法人向けのプランかAPIを使い、個人のアカウントでの業務利用は認めない、と決めるのが分かりやすい線です。
プランや設定の名前は変わることがあるため、契約の前に提供元の最新の説明を確かめてください。学習させないための選び方は「生成AIに機密情報を学習させない方法」で、4つの選択肢に分けてまとめています。
個人情報を入れるときに個人情報保護委員会が求めること
顧客や社員の個人情報を生成AIに入れる場合は、個人情報保護法との関係も考える必要があります。個人情報保護委員会は「生成 AI サービスの利用に関する注意喚起等」(令和5年6月2日)で、事業者に向けて次の2点を挙げています。
- 個人情報を含むプロンプトを入力する場合には、特定された利用目的を達成するために必要な範囲内であることを十分に確認すること
- あらかじめ本人の同意を得ることなく個人データを含むプロンプトを入力し、その個人データが応答結果の出力以外の目的で取り扱われる場合は、個人情報保護法の規定に違反することとなる可能性があるため、提供する事業者が個人データを機械学習に利用しないこと等を十分に確認すること
つまり、個人情報を扱うなら「学習に使われない契約かどうか」は、気をつけたい点ではなく、確かめなければならない点です。迷う情報は入れない、と社内ルールで決めておくと、現場が判断に困りません。
会社でできる対策
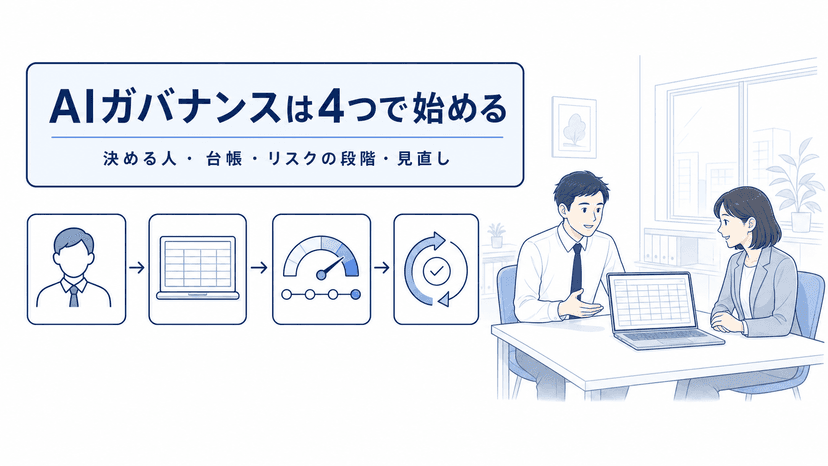
5つの経路を塞ぐ対策は、契約の形、設定、社内ルール、つなぐ先の確かめの4段に分けると整理しやすくなります。
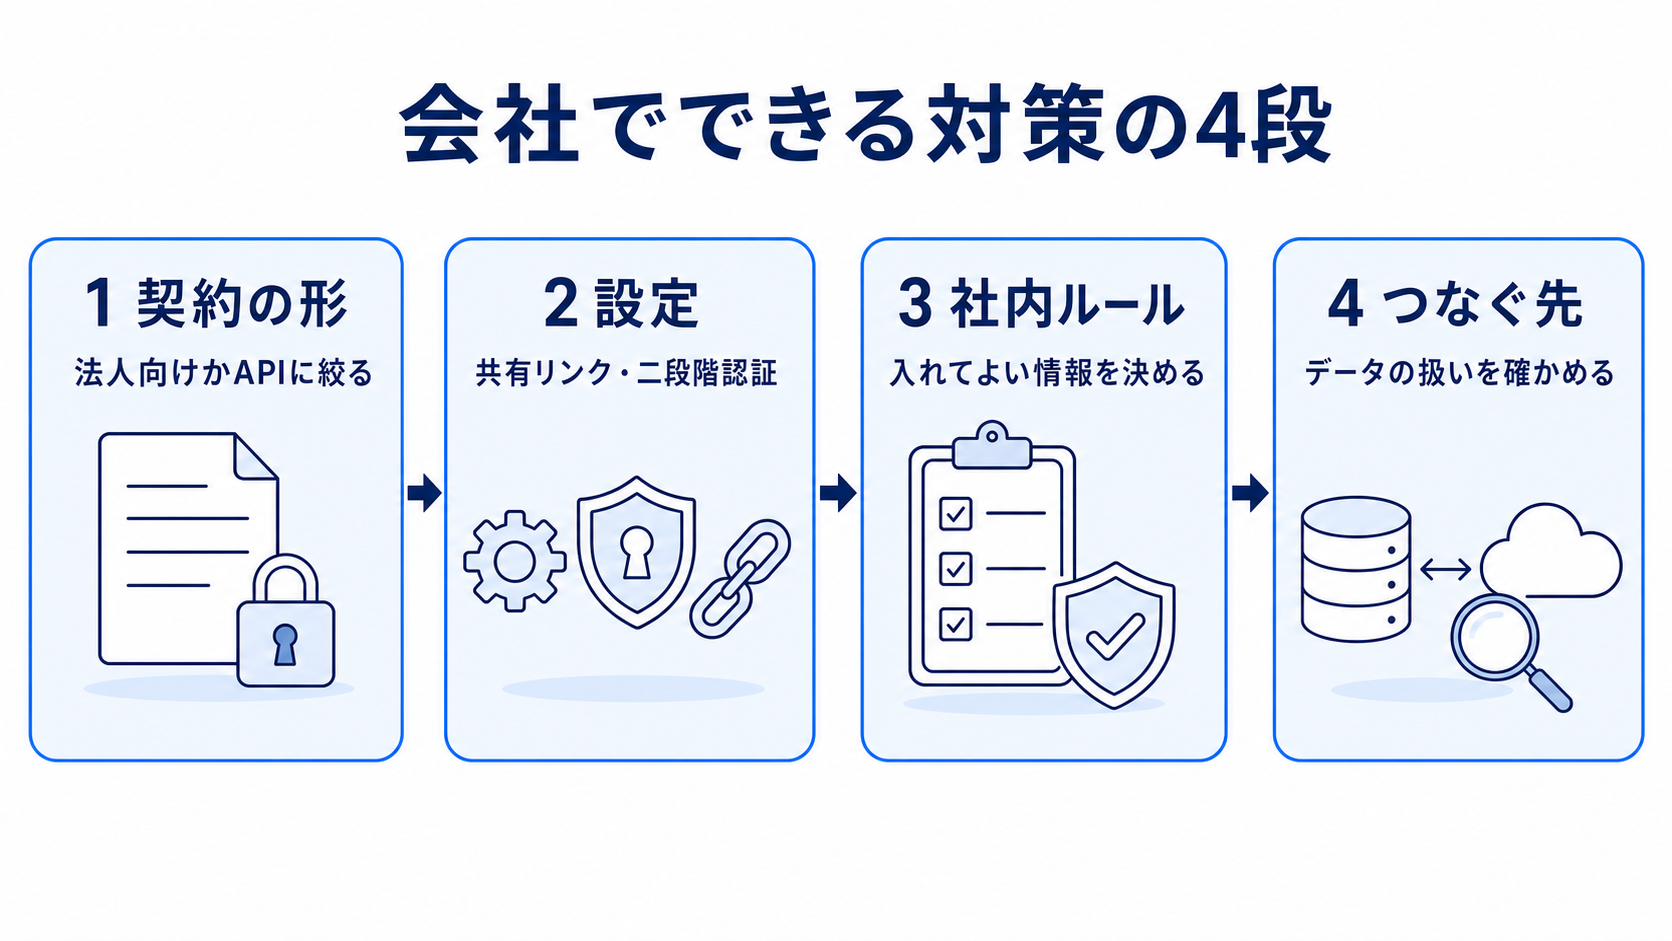
1. 契約の形を決める
業務で使うサービスを、会社で契約した法人向けのプランかAPIに絞ります。学習の扱いが既定で決まり、管理者が利用者を足したり外したりできるため、退職した人のアカウントが残る心配も減ります。会社が認めていないAIを社員が勝手に使う状態(シャドーAIと呼ばれます)を減らすには、禁止するより、使ってよい道具を会社が用意するほうが効きます。
2. 設定をそろえる
共有リンクの扱い、二段階認証、つなぐ先の許可を、会社としてそろえます。共有リンクは社外に出さない、作ったリンクは使い終わったら消す、と決めておくと、3つ目の経路を塞げます。アカウントは二段階認証を必須にし、4つ目の経路に備えます。
3. 社内ルールで「入れてよい情報」を決める
入れてよい情報と入れてはいけない情報を、区分で決めます。顧客の個人情報、契約で外に出せない情報、パスワードや鍵などは入れない、と短く書くだけでも、1つ目の経路の多くを防げます。ルールの作り方とそのまま直して使えるひな型は「生成AIの社内ルールの作り方」で紹介しています。
4. つなぐ先を確かめる
メールやファイル置き場とつなぐ前に、つなぐ先のサービスがデータをどこに置き、何に使うのかを確かめます。社外へ送ること自体が許されない情報を扱う場合は、AIを社内に置く選択もあります。向く場面と必要な機械は「ローカルLLMの導入ガイド」で説明しています。
AIを自社で組む立場から見た「つなぐ先」の確かめ方
当社は、社内の資料をもとに答えるAI「相棒AI」を開発・運用しています。相棒AIは、回答の文章を作るのにAnthropicのClaudeを、資料を探すための下ごしらえ(埋め込み)にOpenAIのモデルを、どちらもAPIで使っています。つまり、1つの仕組みの中で2つの提供元にデータが渡るため、提供元ごとに「学習に使うか」「どれだけの期間残るか」を確かめる必要があります。
自社でAIを組む、あるいは外部のツールを入れるときは、画面に出ているAIの名前だけでなく、裏でどの提供元のどの契約を使っているかを聞いてみてください。たとえば、こういう場面を考えてみます。ある部署が便利な議事録のツールを入れたところ、そのツールが裏で別の会社の生成AIを個人向けに近い条件で使っていた、という場合です。本体のChatGPTを法人向けに切り替えていても、この経路は残ります。
また当社では、AIに作業させるときも、鍵やトークンをチャットや出力に貼らない決まりにしています。入力した内容がどこに残るかを毎回考えるより、入れてはいけないものを最初から決めておくほうが、守りやすいからです。社内の資料で答えるAIの作り方は「社内AIの構築方法」でまとめています。
まとめ|漏洩は経路ごとに塞ぐ
- 生成AIの情報漏洩は、入力・学習・共有リンク・アカウント・つないだ先の5つの経路で起きる
- 学習をオフにしても、提供元の不具合や共有リンク、乗っ取りは防げない
- OpenAIの説明では、法人向けのプランとAPIは既定で学習に使われない。ただし、社外のサーバーで処理されることは変わらない
- 個人情報を入れるなら、個人情報保護委員会の注意喚起どおり、利用目的の範囲と学習に使われないことを確かめる
- 対策は、契約の形・設定・社内ルール・つなぐ先の確かめの4段で決める
全部を一度に決めなくても、まずは業務で使う契約の形を決め、入れてはいけない情報を短く書いて配るところから始めれば、5つの経路の多くは塞げます。そのうえで、つなぐ先が増えるたびに確かめる流れを作っておくと、使える範囲を広げながら守りを保てます。
当社は、社内で安全に使えるAIの仕組みづくりを、データの扱いの整理から開発・運用までご支援しています。導入の前に確かめる点を6つの項目で整理したチェックシートもご用意しています。
よくある質問
- ChatGPTに個人情報を入力してしまったら、漏れますか。
- 入力した内容は提供元のサーバーへ送られ、個人向けのプランで学習の設定がオンなら学習に使われることがあります。すぐ他人の答えに出るとは限りませんが、会社の情報なら担当者に報告し、会話の削除と共有リンクの確認をしてください。
- 学習の設定をオフにすれば、情報漏洩は防げますか。
- 学習の経路は塞げますが、それだけでは足りません。共有リンクの公開、アカウントの乗っ取り、つないだ先のサービス、提供元の不具合による漏洩は、学習の設定とは別に対策が要ります。
- 無料版のChatGPTを業務に使ってもよいですか。
- 会社として決めておく必要があります。OpenAIの説明では、個人向けのプランは既定で学習に使われる設定で、会社が社員の設定を確かめる手段もないため、業務は会社で契約した法人向けのプランかAPIに絞る形が分かりやすくなります。
- APIで使えば、入力した内容は社外に残りませんか。
- OpenAIの説明では、APIに送ったデータは学習に使われませんが、不正利用の監視の記録が既定で最大30日残ります。学習に使われないことと、社外に渡らないことは別のことです。
- 個人情報を生成AIに入れるとき、法律上なにを確かめればよいですか。
- 個人情報保護委員会は、利用目的の範囲内かを確かめること、本人の同意なく入れる場合は提供する事業者が機械学習に使わないこと等を十分に確かめることを求めています。
次に読む記事
PoC止まりのAIを立て直すには|止まる理由と、やり直す前に確かめる5つのこと
記事を読むこの記事を書いた人
株式会社デイワン 代表取締役 月森 隼人
不動産コンサルタント、注文住宅やマンションなどの企画営業を経験し、大手広告代理店のデジタル部署にて、Web領域でのブランディングややディレクションなど上流から幅広く担当。