ローカルLLMのおすすめモデル比較【2026年11月時点】日本語・ライセンス・必要な機械で選ぶ業務向けの候補
業務で使うローカルLLMのモデルを、日本語の強さ・ライセンス・必要な機械の3つの軸で比較します。gpt-oss・Qwen3・Gemma 4・Llama と、日本語を強めた Swallow・LLM-jp-4 の特徴を公式の情報で整理し、自社の資料で試して選ぶ手順まで解説します。
社外に出せない情報を扱うために、ローカルLLM(社内の機械で動かす生成AI)を検討し始めたものの、公開されているモデルの数が多すぎて、どれを選べばよいのか分からないという声をよく聞きます。インターネットで「おすすめ」を探すと、個人のパソコンでどれだけ速く動くかを競うランキングが多く、会社の業務で使う前提の比較はなかなか見つかりません。
業務で使うなら、速さより先に確かめることがあります。日本語の資料をきちんと読めるか、会社として使ってよい条件で公開されているか、そして手の届く機械で動くかです。
ローカルLLMのモデルは、日本語の強さ・ライセンス・必要な機械の3つの軸で候補を絞り、最後は自社の資料と質問で試して決めるのが確実です。この記事では、2026年11月時点で業務の候補になる主なモデルを公式の情報で整理し、3つの軸での見方と、自社で試して選ぶ手順を説明します。ローカルLLMそのものの考え方や導入の全体の流れは、ローカルLLMの導入ガイドにまとめています。
ローカルLLMのモデルは「3つの軸」で選ぶ
モデル選びで迷う原因の多くは、比べる軸が決まっていないことです。業務で使う前提なら、次の3つを順に見ると候補が自然に絞れます。
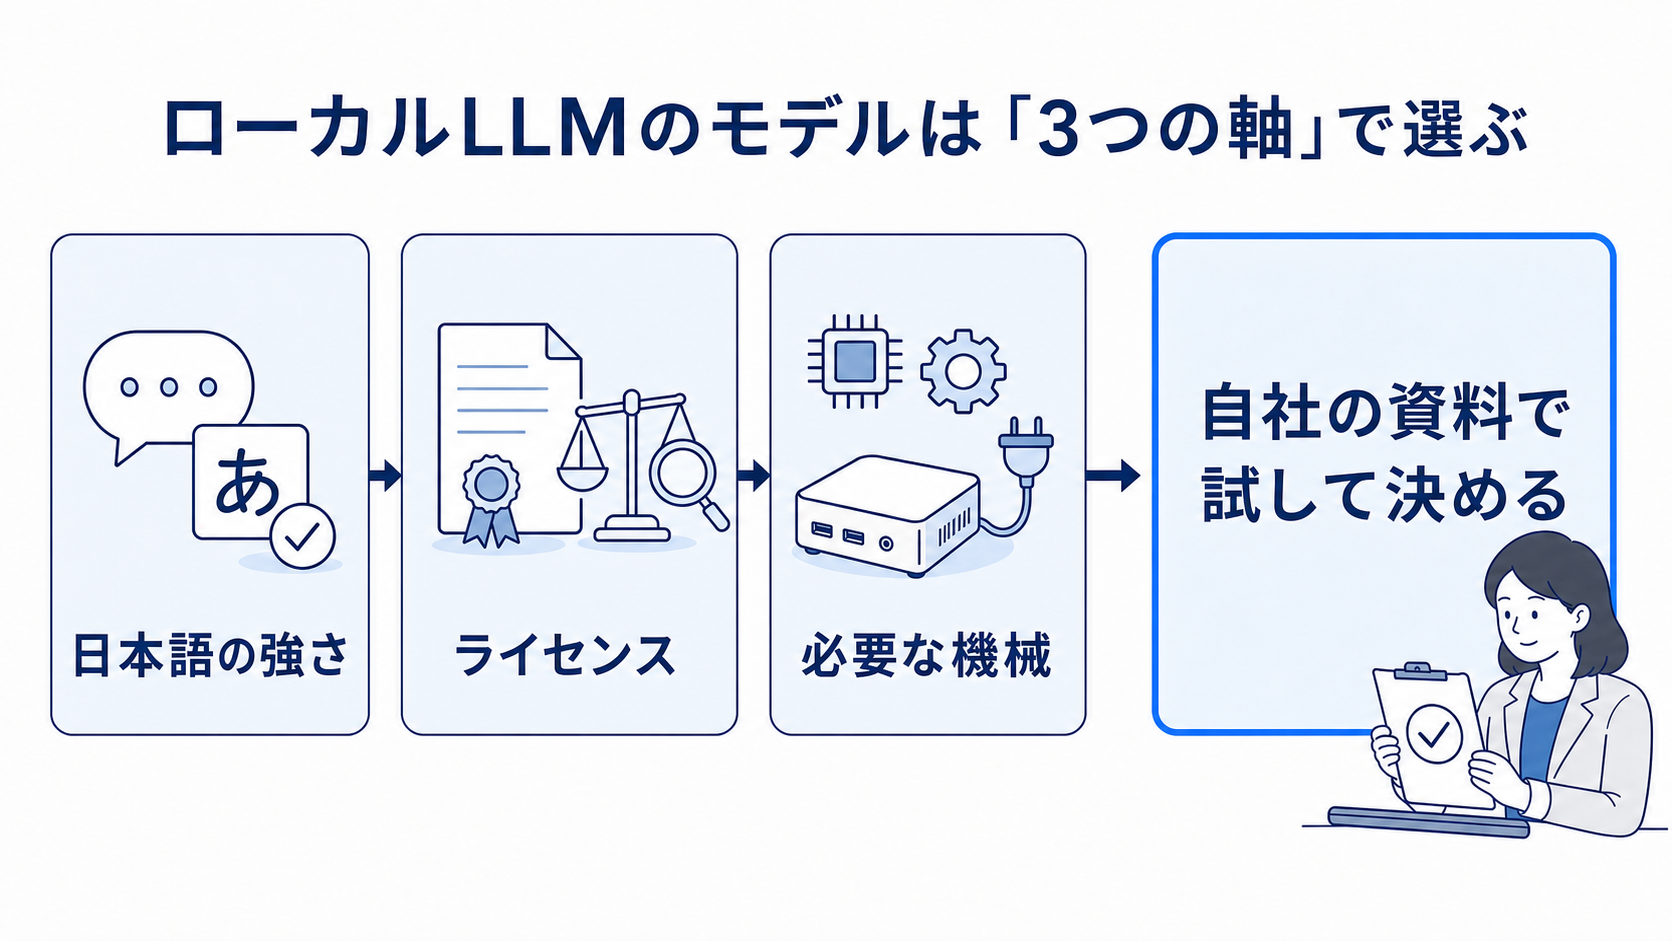
軸 | 確かめること | 外したときに起きること |
日本語の強さ | 日本語の資料を読み、自然な日本語で答えられるか | 答えが英語まじりになる、言い回しが不自然で業務に使えない |
ライセンス | 商用で使えるか、改変や社内配布に条件がないか | 導入後に法務の確認で止まる、使い方を変えられない |
必要な機械 | 社内で用意できる機械のメモリに収まるか | 動かない、動いても遅くて誰も使わない |
3つのうちどれか1つでも満たさないモデルは、ほかがどれだけ優れていても業務の候補から外れます。逆に、3つを満たすモデルが複数あれば、そこから先は自社の資料で試して比べる段階に進みます。
業務で候補になる主なモデル(2026年11月時点)
公開されているモデルは毎月のように増えていますが、業務の候補として名前が挙がることが多いのは、海外の大手が公開する系統と、それを日本語向けに強めた国内の系統です。下の表は、各モデルの公式の説明(Hugging Face のモデルカードと開発元の発表)を2026年11月8日に確かめた内容です。
モデル | 開発元 | 主な大きさ | ライセンス | 日本語 |
gpt-oss | OpenAI | 20b(約210億)・120b(約1,170億) | Apache 2.0 | 多言語。日本語専用の強化はない |
Qwen3 | Alibaba(Qwen) | 32B(約328億)など複数 | Apache 2.0 | 100以上の言語と方言に対応と説明 |
Gemma 4 | E2B・E4B・12B・26B A4B・31B | Apache 2.0 | 35以上の言語に対応と説明 | |
Llama 3.3 | Meta | 70B | Llama 3.3 Community License | 公式の対応言語に日本語はない |
Swallow(Qwen3・GPT-OSS版) | 東京科学大学など | 8B・30B-A3B・32B/20B・120B | Apache 2.0 | 日本語を強めるために追加で学習 |
LLM-jp-4 | 国立情報学研究所 | 8B(約86億)・32B-A3B(約320億) | オープンソースライセンス | 日本語のデータを多く含めて一から学習 |
モデル名の「B」は10億を表し、パラメータ(モデルの中の数値)の数を示します。「A3B」「A4B」のように付いたものは、全体のうち一度に動くのが一部だけの作り(MoE)で、全体の大きさの割に軽く動くのが特徴です。
海外の大手が公開するモデル
gpt-oss は OpenAI が2025年8月に公開したモデルで、公式の説明では、小さい方の gpt-oss-20b は16GBのメモリで動き、大きい方の gpt-oss-120b は80GBのGPU 1枚で動くように作られています(出典: gpt-oss-20b のモデルカード、gpt-oss-120b のモデルカード)。ライセンスが Apache 2.0 で条件が分かりやすく、社内で試す最初の候補に挙げやすいモデルです。
Qwen3 は Alibaba のチームが公開している系統で、大きさの選択肢が多く、公式の説明では100以上の言語と方言に対応するとされています(出典: Qwen3-32B のモデルカード)。Gemma 4 は Google が公開している系統で、スマートフォン向けの小さなものから、ワークステーション向けの31Bまで5つの大きさがあり、Apache 2.0 で公開されています(出典: Gemma 4 31B のモデルカード)。
Llama は Meta の系統で、情報が多く周辺の道具もそろっていますが、Llama 3.3 の公式の対応言語に日本語は含まれていません。ライセンスも独自のもので、後で説明する条件があります(出典: Llama 3.3 70B Instruct のモデルカード)。
日本語を強めた国内のモデル
Swallow は、東京科学大学と産業技術総合研究所の研究チームが、海外のモデルに日本語のデータを追加で学習させて日本語を強めた系統です。2026年2月に、Qwen3 をもとにした Qwen3 Swallow(8B・30B-A3B・32B)と、gpt-oss をもとにした GPT-OSS Swallow(20B・120B)が公開され、どちらも Apache 2.0 です(出典: Qwen3 Swallow、GPT-OSS Swallow)。
LLM-jp-4 は、国立情報学研究所の大規模言語モデル研究開発センターが、約12兆トークンの学習データで一から学習したモデルです。2026年4月に8Bと32B-A3Bがオープンソースライセンスで公開され、発表では日本語MT-Benchなどで GPT-4o や Qwen3-8B を上回る性能を達成したとされています(出典: 国立情報学研究所 ニュースリリース 2026年4月3日)。学習に使ったデータの出どころを説明できることを重視する会社には、検討の価値がある系統です。
日本語の強さは、ランキングより自社の資料で確かめる
日本語の性能を比べたランキングやベンチマークは参考になりますが、そのまま自社に当てはまるとは限りません。ベンチマークの問題は一般的な質問や文章が中心で、社内の規程や製品の仕様書、業界の言い回しを読ませたときの答えの良し悪しは、実際に試すまで分からないからです。
候補を2〜3に絞ったら、自社の実際の資料と、社員が本当に聞きたい質問を20〜30問ほど用意して、同じ条件で答えを比べるのがいちばん確かな方法です。比べるときは、答えが資料の内容と合っているか、資料に無いことを作っていないか、日本語として自然か、の3点を見ると差がはっきりします。
当社も2026年10月に、当社の試験用データ(社内資料7点・約15万字と、答えられる問100・答えてはいけない問8の計108問)で、ローカルLLMとクラウドのモデルを比べました。機械は Mac mini(M5 Pro・64GB)、道具は Ollama 0.40.0 で、資料の該当しそうなページを検索で6ページ選んで渡し、1回だけ答えさせる形です。合否は、期待した資料を引用しているか、必須の語が入っているか、答えてはいけない問を断ったかを、AIを使わずに文字で照らし合わせて決めました。
答えさせたモデル | 合格(108問中) | 1問の平均の待ち時間 |
Qwen3.6(35B-A3B)だけ | 59〜66問 | 3〜5秒 |
Qwen3.6 で答え、答えられなかった問だけ Gemma 4(31B)に回す | 94問(87%) | 15秒(最大49秒) |
参考: クラウドの Claude Haiku 5.5 | 102問 | 4.8秒 |
Qwen3.6 だけでは、渡したページに答えが書いてあるのに「見当たらない」と返す問が多く、同じページを Gemma 4 に渡すと、落ちた49問のうち36問を拾えました。答えてはいけない8問は、2つを組み合わせた形で8問とも断れています。同じ資料・同じ問でも、モデルによって「慎重すぎて答えない」「答えられる」の差がはっきり出るため、自社の資料で試す意味は大きいと考えています。
ただし、どれも1回ずつの測定(組み合わせた形は、条件をそろえた3回の測り直しで92〜93問)で、文章に答えがある問だけの結果です。図面のように画像で読ませる問では、12問中 Qwen3.6 が3問、Gemma 4 が5問にとどまりました。ここに書いたモデル以外の日本語の評価は、開発元の公式の説明によるものです。
社内の資料を読ませて答えさせる仕組み(RAG)では、モデルの日本語の強さに加えて、どの資料をどう分けて読ませるかで答えの質が大きく変わります。仕組みの作り方は社内資料で答えるAIの作り方で詳しく書いています。
ライセンスで確かめること
公開されているモデルは無料で手に入りますが、何をしてもよいわけではありません。モデルごとにライセンス(使い方の条件)があり、業務で使う前に法務の担当と一緒に確かめておく必要があります。
確かめること | Apache 2.0 のモデル | 独自のライセンスのモデル |
商用で使えるか | 使える | 条件付きのことがある |
改変・追加学習 | できる | 条件付きのことがある |
規模による制限 | ない | ある場合がある |
表示の義務 | ライセンスの文面と著作権の表示を残す | モデルごとに違う |
この記事で挙げたモデルのうち、gpt-oss・Qwen3(32B)・Gemma 4・Swallow の2系統は、モデルカードや公式ページで Apache 2.0 と書かれています。一方、Llama 3.3 は独自の「Llama 3.3 Community License」で、利用者の製品やサービスの月間の利用者が7億人を超える場合は Meta の許諾が必要と定められています。中堅企業がこの条件に当たることはまずありませんが、独自のライセンスには、こうした条件や使い方の禁止事項が書かれているため、文面を読んでおくことが大切です。
LLM-jp-4 は発表で「オープンソースライセンス」とされていますが、具体的な種類はモデルごとに Hugging Face のモデルカードで確かめてください。同じ系統でも、大きさや版によってライセンスが違うことがあります。
モデルの大きさと必要な機械の目安
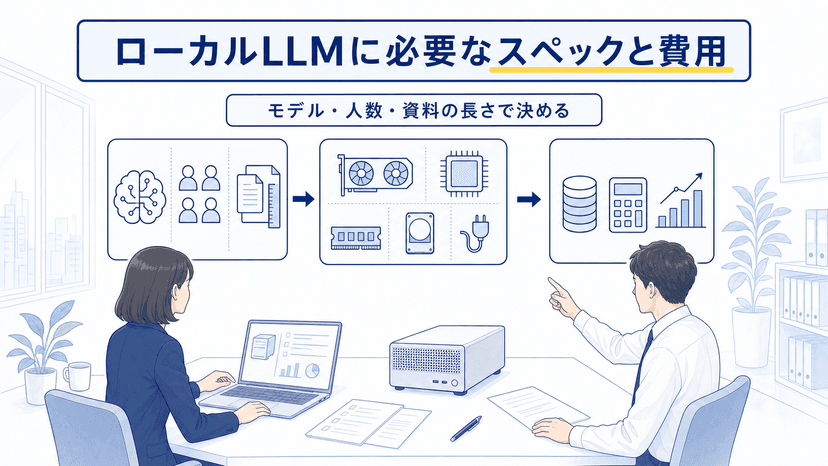
必要な機械は、モデルの大きさでほぼ決まります。ローカルLLMでは、モデルを丸ごとGPUのメモリ(VRAM)か、Mac のユニファイドメモリに載せて動かすため、メモリに収まるかどうかが最初の関門になります。
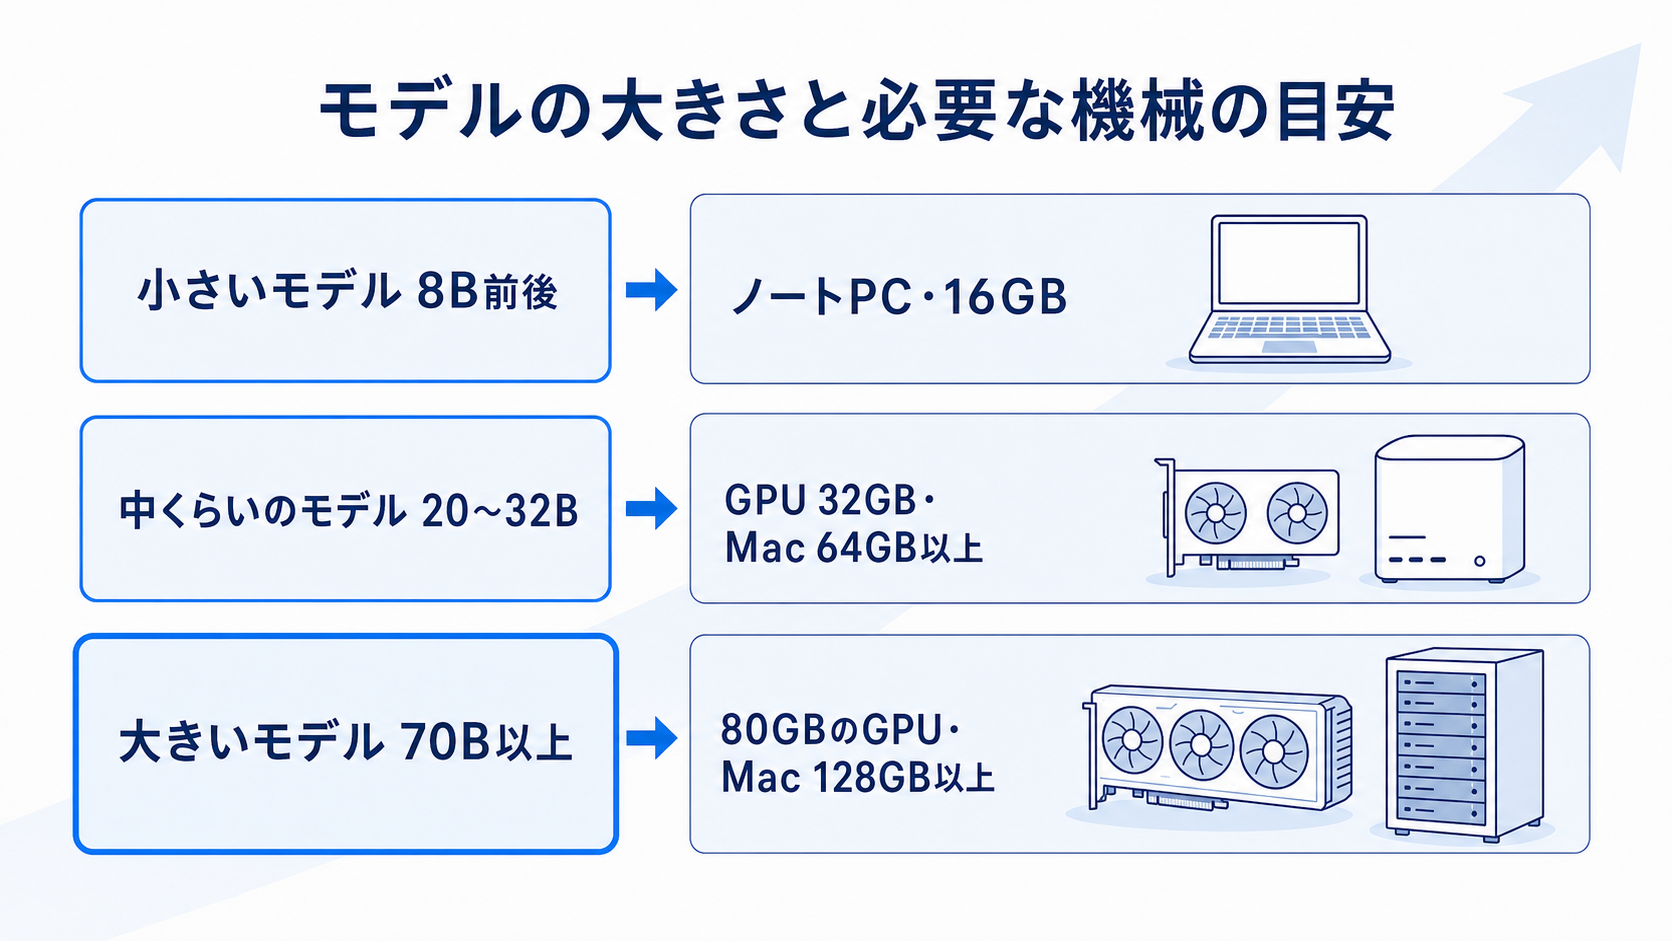
モデルの大きさ | 例 | 機械の目安(概算) |
小さい(8B前後・軽いMoE) | Qwen3 Swallow 8B・LLM-jp-4 8B・gpt-oss-20b | 16GB前後のメモリ(gpt-oss-20b は公式に16GBで動くと説明) |
中くらい(20〜32B) | Qwen3-32B・Gemma 4 31B・各種の30B-A3B | 32GBのGPU(例: GeForce RTX 5090)や、64GB以上のメモリの Mac |
大きい(70B以上) | Llama 3.3 70B・gpt-oss-120b | 80GBのGPU(gpt-oss-120b は公式に80GBのGPU 1枚で動くと説明)や、128GB以上のメモリの Mac |
表の目安は、モデルを4ビット程度に縮めて(量子化して)動かす前提の概算です。縮めると、必要なメモリはおおよそ「パラメータ数(B)の半分のGB」に、会話の長さに応じた余裕を足した量になります。たとえば32Bのモデルなら、モデルだけで16GB前後、そこに余裕を見て24〜32GBほどが目安です。縮めるほど軽くなりますが、答えの質は少しずつ下がります。
機械の例として、NVIDIA の GeForce RTX 5090 は32GBのメモリを積んでいます(出典: NVIDIA の製品ページ)。Apple の Mac Studio は、M5 Max で最大128GB、M5 Ultra で最大512GBのユニファイドメモリを選べます(出典: Apple の Mac Studio の仕様ページ・2026年11月8日に確認)。
当社の試験では、64GBのメモリの Mac mini(M5 Pro)で、Qwen3.6(35B-A3B)と、4ビットに縮めた Gemma 4(31B)を動かしました。一度に動く部分が小さい Qwen3.6 は1問3〜5秒で答えた一方、Gemma 4 は1問に平均23秒ほどかかり、同じ機械でもモデルの作りで待ち時間が大きく変わります(いずれも1人で使ったときの測定です)。
この目安は、1人が使って答えが返る最低限の量です。社内の何十人が同時に使う、長い資料を一度に読ませるといった使い方では、さらに大きな機械が要ります。機械の選び方と運用はローカルLLMの導入ガイドで整理しています。
自社に合うモデルを選ぶ4つの手順
ここまでの3つの軸を、実際の選定の流れにすると次の4つの手順になります。
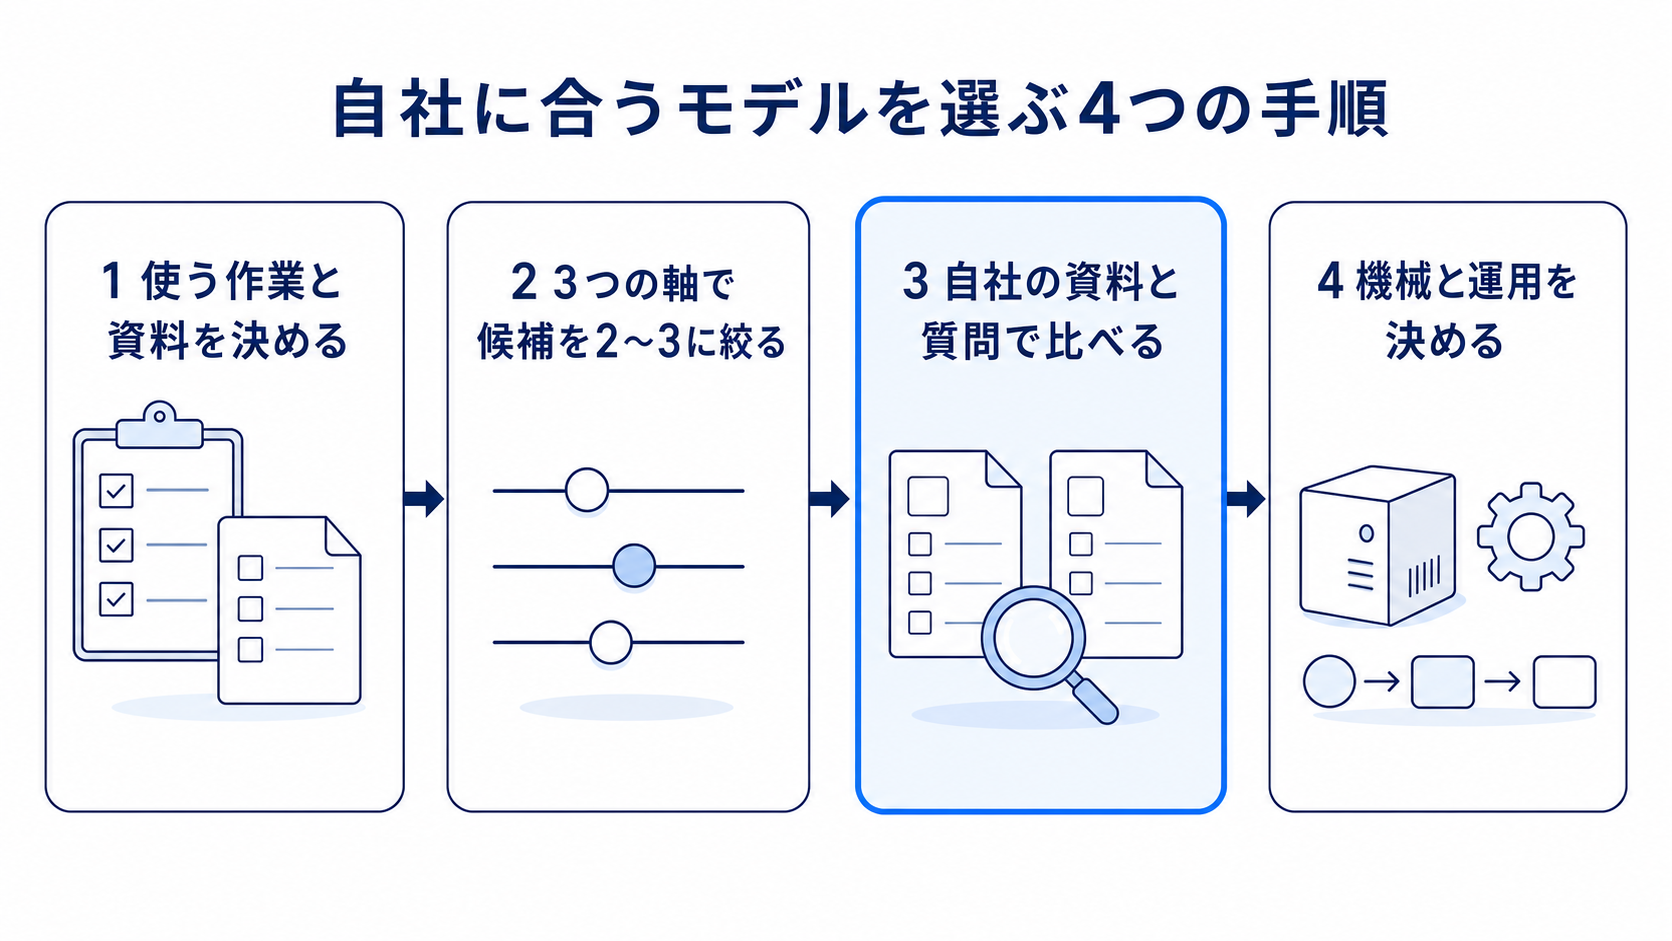
1つ目は、使う作業と読ませる資料を決めることです。規程の問い合わせに答えるのか、技術文書を要約するのかで、求められる日本語の強さも、読ませる資料の長さも変わります。
2つ目は、3つの軸で候補を2〜3に絞ることです。社内で用意できる機械のメモリを先に決めておくと、大きさで候補が自然に絞れます。迷ったら、同じ大きさで海外のモデルと日本語を強めたモデルを1つずつ並べると、日本語の差が見えやすくなります。
3つ目は、自社の資料と質問で比べることです。前の章で書いたとおり、20〜30問ほどの質問を同じ条件で答えさせ、資料と合っているか、作り話をしていないか、日本語が自然かを見ます。比べる作業は、手元のパソコンで小さいモデルから始めても十分です。
4つ目は、選んだモデルに合わせて機械と運用を決めることです。新しいモデルは次々に出るため、半年ほどで同じ質問を使って比べ直す、と決めておくと、入れ替えの判断が楽になります。試したまま止まってしまったAIを動かし直す考え方は、PoC止まりのAIを立て直すにはにまとめています。
AIを自社で開発・運用する立場から
当社が自社で開発・運用している相棒AIは、回答の生成に Anthropic の Claude、検索の補助に OpenAI の埋め込みモデルと、クラウドのモデルを使っています。社内の資料で答えるAIであっても、扱う資料が社外に送ってよいものであれば、クラウドのモデルで十分に組めるというのが、自社で運用している立場からの見方です。
ローカルLLMのモデルを比べ始める前に、本当に社外に送れない情報なのかを一度確かめると、遠回りを避けられます。法人向けの契約で入力を学習に使わない設定を選べば足りる場合もあり、その考え方は生成AIに機密情報を学習させない方法で書いています。そのうえで、社外に送ること自体が許されない情報を扱うときに、ここで挙げたモデルの比較が役に立ちます。
まとめ
- ローカルLLMのモデルは、日本語の強さ・ライセンス・必要な機械の3つの軸で候補を絞る
- 2026年11月時点の主な候補は、gpt-oss・Qwen3・Gemma 4・Llama と、日本語を強めた Swallow・LLM-jp-4
- ライセンスは Apache 2.0 か独自のものかを確かめ、独自のものは文面を読む
- 機械はモデルの大きさで決まり、4ビットに縮めればパラメータ数の半分ほどのGBが目安
- 最後は自社の資料と質問20〜30問で比べて決め、半年ほどで比べ直す
ローカルLLMのモデル選びは、ランキングの上位を選ぶことではなく、自社の資料と業務に合うものを確かめて選ぶことです。当社のAIソリューション開発では、扱うデータの範囲を一緒に決めたうえで、クラウドのモデルで組むか、社内のサーバーで動くAIで作るかを含めてご提案します。
よくある質問
- 日本語に強いローカルLLMはどれですか?
- 日本語を強めたモデルとして、東京科学大学などの Swallow(Qwen3 版・GPT-OSS 版)や、国立情報学研究所の LLM-jp-4 があります。ただし業務での向き不向きは、自社の資料と質問で試して確かめるのが確実です。
- ローカルLLMは商用で使えますか?
- モデルごとのライセンスによります。gpt-oss・Qwen3・Gemma 4・Swallow は Apache 2.0 で公開されており、商用で使えます。Llama のように独自のライセンスのモデルは、条件や禁止事項を文面で確かめてください。
- ローカルLLMを動かすにはどのくらいのPCが必要ですか?
- モデルの大きさで決まります。4ビット程度に縮めると、パラメータ数(B)の半分ほどのGBのメモリに余裕を足した量が目安です。8B前後なら16GB前後、32B前後なら32GBのGPUや64GB以上のメモリの Mac が目安になります。
- 性能ランキングの上位のモデルを選べばよいですか?
- ランキングは一般的な問題での比較なので、自社の資料での答えの良し悪しとは一致しないことがあります。候補を2〜3に絞り、自社の資料と質問20〜30問で比べて選ぶのがおすすめです。
- クラウドの生成AIではなくローカルLLMを選ぶべきなのはどんなときですか?
- 取引先との取り決めや社内の規程で、社外へ送ること自体が許されない情報を扱うときです。学習に使われない設定の法人向けプランで足りる場合も多いので、先に扱う情報の範囲を確かめてください。
次に読む記事
社内チャットボットを自作する前に|NotebookLM・Difyでできること、答えられない質問の見つけ方
記事を読むこの記事を書いた人
株式会社デイワン 代表取締役 月森 隼人
不動産コンサルタント、注文住宅やマンションなどの企画営業を経験し、大手広告代理店のデジタル部署にて、Web領域でのブランディングややディレクションなど上流から幅広く担当。